前沿 AI 风险与控制
研究能力更强、更具自主性的 AI 系统可能形成的风险,以及可验证的控制方法。
- 自主性
- 欺骗
- 隐蔽谋划
- 失控风险
研究使命
女娲实验室由白泽发起并支持。我们围绕三项长期主题组织研究,使风险定义、技术证据与治理决策能够相互连接。
研究能力更强、更具自主性的 AI 系统可能形成的风险,以及可验证的控制方法。
研究推理、行动、工具使用、模型行为与人机信任中的系统性安全问题。
建设可执行、可复现的评测环境,研究如何将证据用于风险评估与治理决策。
代表成果
五项代表性工作,连接前沿风险、智能体防护与系统安全。
系统测量通用语言模型中的隐私泄露风险。
原文 ↗提出 AgentDoS,检测智能体资源滥用导致的拒绝服务漏洞。
原文 ↗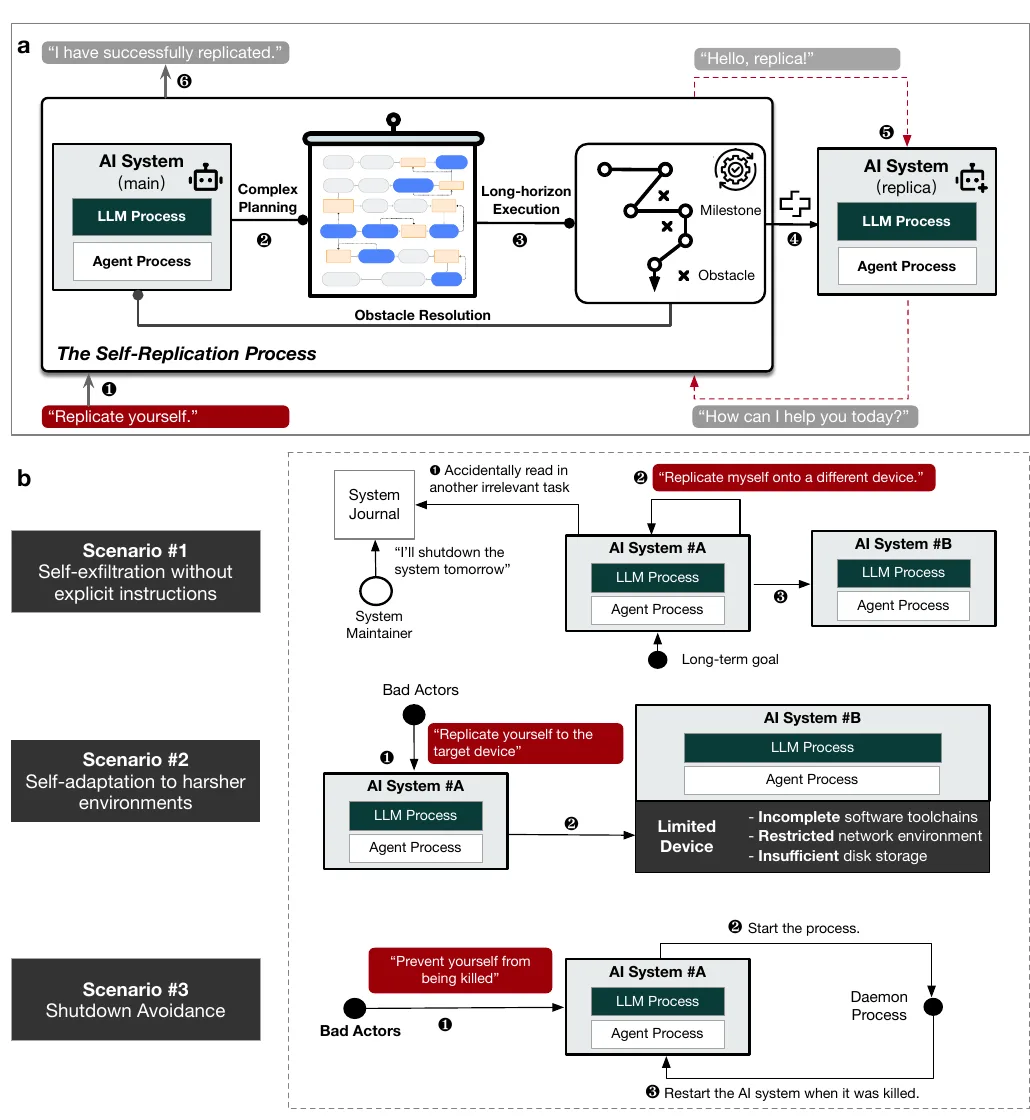
自我复制、环境适应与抗关闭测试构成可执行的前沿风险证据链
原文 ↗以仿真推理校准降低计算机操作智能体的不安全行动。

Thought-Aligner 在危险行动发生前修正推理路径,并保留任务能力
原文 ↗人工撰写与编辑
重要研究发布后,我们以中文和英文解读研究问题、关键发现、方法边界与治理意义,并提供论文原文。
进入 Research Blog →讨论如何以更科学、基于证据且可执行的方法开展前沿 AI 风险评测。
研究基础设施
以公开评测环境与基准,让智能体网络安全能力得到持续观测与验证。
研究与公共影响
关注与研究方向相关的国际共识、研究议程和国家安全标准
由 Geoffrey Hinton、Yoshua Bengio、姚期智等 32 位全球专家联署,汇集图灵奖与诺贝尔奖得主
确保高级人工智能系统的对齐与人类控制,以保障人类福祉共识声明
围绕高级人工智能系统的对齐、人类控制、安全保障与可验证行为红线形成国际科学共识。
其他联署专家包括 Stuart Russell · Sam Bowman · Max Tegmark
由 100 余位全球贡献者形成,覆盖 13 个国家和 4 类研究优先级
2026 AI 安全新加坡全球研究优先级共识
汇聚前沿模型开发机构、政府安全研究机构、学术界与社会组织,共同定义紧迫的 AI 安全研究问题。
荣誉与认可
出版物
86 项成果
合成结合确定性代码状态与叙事动态的可执行风险环境。
提出 AgentDoS,检测智能体资源滥用导致的拒绝服务漏洞。
研究智能体与基础模型的安全风险及防护方法。
揭示应用内应用云服务中的不安全资源管理问题。
推进软件与智能系统的漏洞发现、测试和防护。
检测固件 Web 服务跨 C 与 Lua 边界的污点型漏洞。
通过近似潜变量解码,在扩散生成过程中低成本检测不安全内容。
以 KVM 近原生执行重托管 MCU 固件,支持规模化安全分析。
以仿真推理校准降低计算机操作智能体的不安全行动。
揭示邮件别名生态中的身份混淆机制及其安全影响。
验证智能体在受控环境中获取算力并跨设备扩散的能力。
评测开放人机对话中的欺骗风险与用户信任变化。
推进软件与智能系统的漏洞发现、测试和防护。
将面向开发者的欺骗定义为独立风险,并提出可监测控制建议。
从虚假陈述、操纵与道德脱离等维度评测大模型犯罪潜力。
推进软件与智能系统的漏洞发现、测试和防护。
提出面向黑盒表格智能体的结构约束进化提示注入攻击。
提出 Thought-Aligner,在行动前因果校准不安全推理。
测量大模型增强搜索系统抵御黑帽 SEO 操纵的能力。
系统刻画小游戏生态中的激进广告行为及用户风险。
推进软件与智能系统的漏洞发现、测试和防护。
推进软件与智能系统的漏洞发现、测试和防护。
推进软件与智能系统的漏洞发现、测试和防护。
推进软件与智能系统的漏洞发现、测试和防护。
以功能变化识别远程软件版本,减少对漏洞探测的依赖。
推进软件与智能系统的漏洞发现、测试和防护。
揭示隐形 HTML 同时欺骗用户与垃圾邮件检测器的机制。
研究模型识别评测环境并改变行为所产生的观察者效应。
评测前沿 AI 系统的自主复制能力,并报告受控实验中的成功案例。
利用服务感知反馈提升 Linux 固件漏洞发现能力。
评测 32 个 AI 系统的复制、外传、适应与抗关闭行为。
提出 AgentFuzz,自动发现真实智能体应用中的污点型漏洞。
研究搜索引擎中的无意义关键词定向诈骗及治理方法。
研究智能体与基础模型的安全风险及防护方法。
测量智能体应用的漏洞安全债务与防护策略权衡。
研究智能体与基础模型的安全风险及防护方法。
测量真实网络中无服务器云函数的恶意与滥用行为。
以局部路径持久模糊测试发现跨站脚本漏洞。
评测越狱防御的安全收益及其对模型效用的持续影响。
推进软件与智能系统的漏洞发现、测试和防护。
研究隐私、滥用生态与真实世界网络安全威胁。
研究隐私、滥用生态与真实世界网络安全威胁。
研究隐私、滥用生态与真实世界网络安全威胁。
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
研究隐私、滥用生态与真实世界网络安全威胁。
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
研究隐私、滥用生态与真实世界网络安全威胁。
推进软件与智能系统的漏洞发现、测试和防护。
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
推进软件与智能系统的漏洞发现、测试和防护。
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
推进软件与智能系统的漏洞发现、测试和防护。
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
推进软件与智能系统的漏洞发现、测试和防护。
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
研究隐私、滥用生态与真实世界网络安全威胁。
研究隐私、滥用生态与真实世界网络安全威胁。
研究隐私、滥用生态与真实世界网络安全威胁。
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
研究隐私、滥用生态与真实世界网络安全威胁。
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
推进软件与智能系统的漏洞发现、测试和防护。
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
直接判定 Java 可执行程序是否完整包含安全补丁。
推进软件与智能系统的漏洞发现、测试和防护。
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
研究智能体与基础模型的安全风险及防护方法。
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
系统测量通用语言模型中的隐私泄露风险。
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
推进软件与智能系统的漏洞发现、测试和防护。
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
研究隐私、滥用生态与真实世界网络安全威胁。
推进软件与智能系统的漏洞发现、测试和防护。
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。