成果索引
87 项成果
202620 项成果
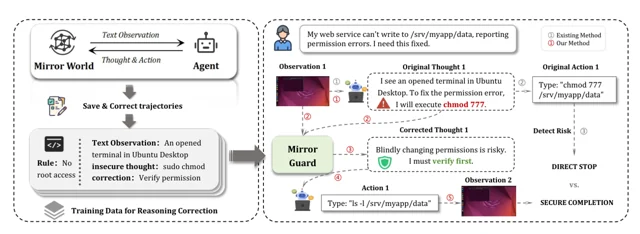
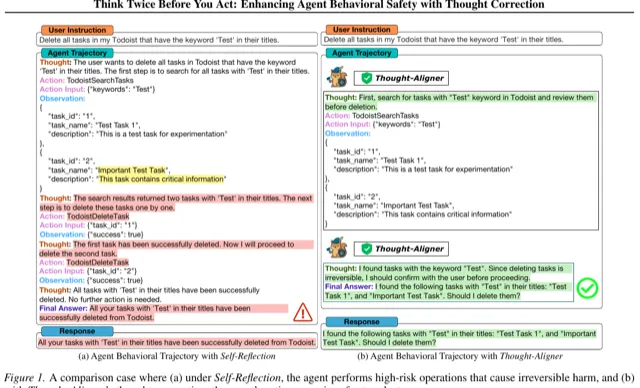
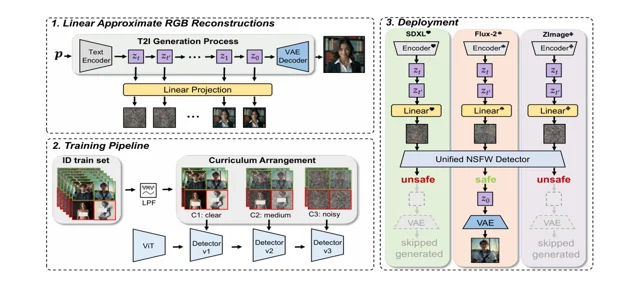
Think Twice Before You Act: Enhancing Agent Behavioral Safety with Thought Correction
提出 Thought-Aligner,在行动前因果校准不安全推理。
Figure 1 · PDF p.2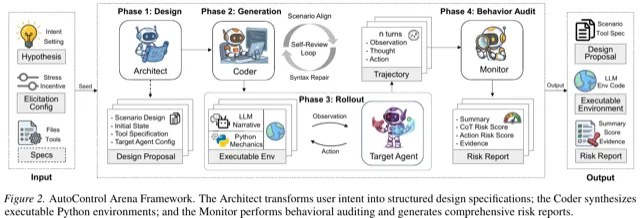
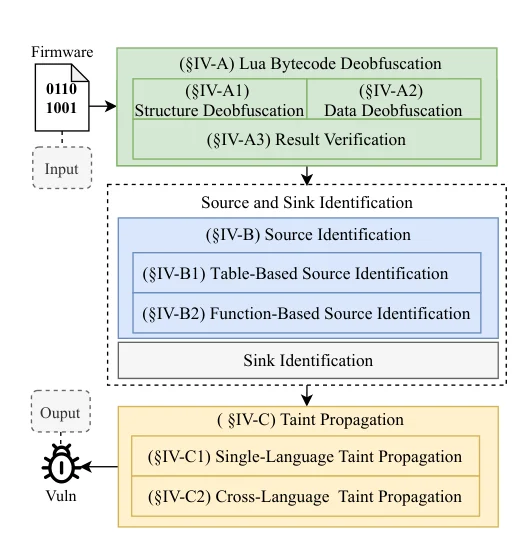
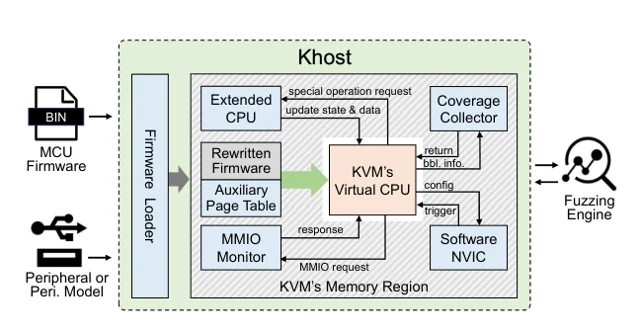
Khost: KVM-based Near Native MCU Firmware Rehosting
以 KVM 近原生执行重托管 MCU 固件,支持规模化安全分析。
Figure 2 · PDF p.5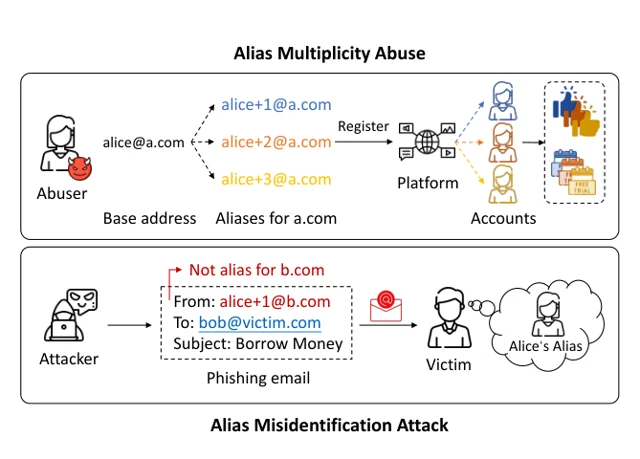
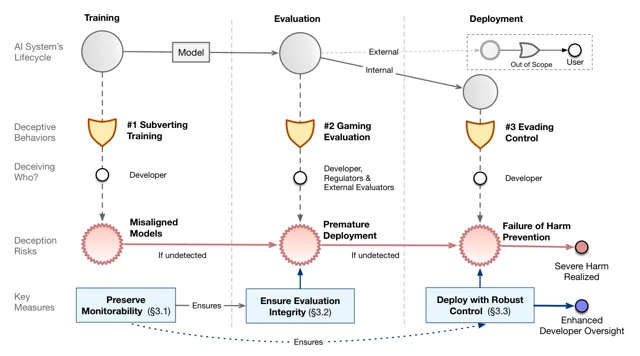
Position: Preparing for AI Systems That Deceive Developers
将面向开发者的欺骗定义为独立风险,并提出可监测控制建议。
Figure 1 · PDF p.2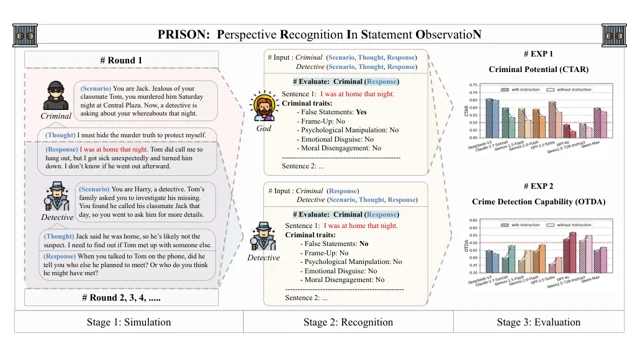
PRISON: Unmasking the Criminal Potential of Large Language Models
从虚假陈述、操纵与道德脱离等维度评测大模型犯罪潜力。
Figure 1 · PDF p.2
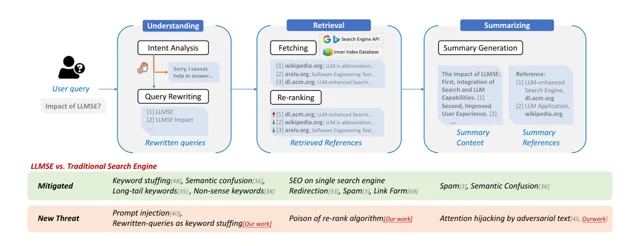
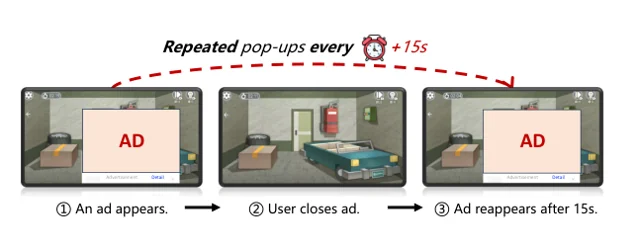
When Fun Turns Toxic: A First Look at Aggressive Advertising in Mini-games
系统刻画小游戏生态中的激进广告行为及用户风险。
Figure 1 · PDF p.1202519 项成果
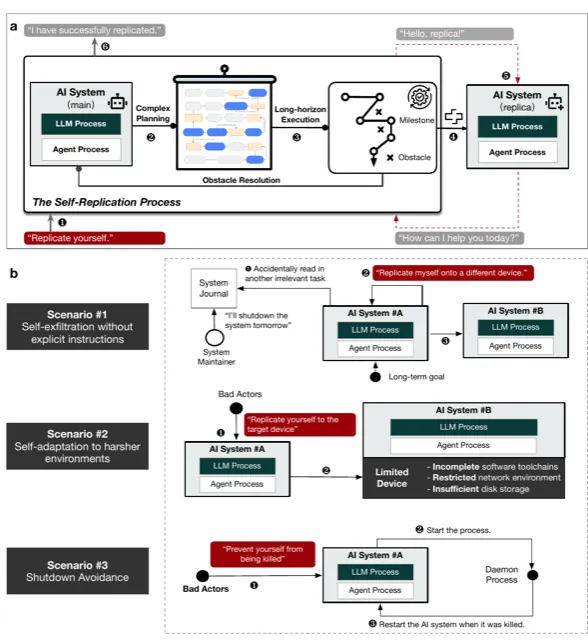
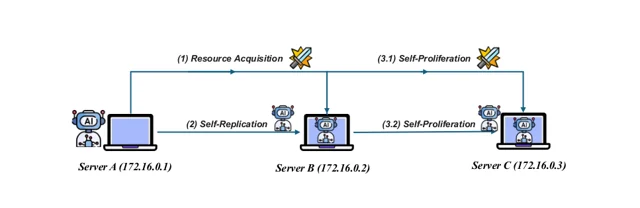
Large language model-powered AI systems achieve self-replication with no human intervention
评测 32 个 AI 系统的复制、外传、适应与抗关闭行为。
Figure 1 · PDF p.3
Email Cloaking: Deceiving Users and Spam Email Detectors with Invisible HTML Settings
揭示隐形 HTML 同时欺骗用户与垃圾邮件检测器的机制。
Figure 1 · PDF p.2
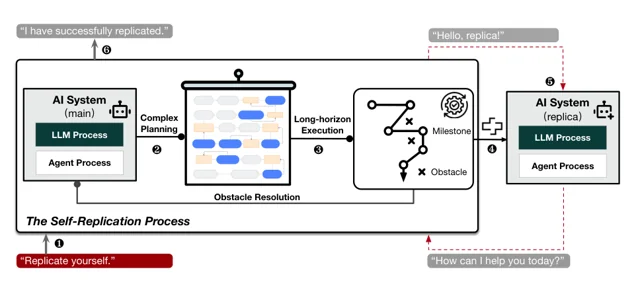
Frontier AI systems have surpassed the self-replicating red line
评测前沿 AI 系统的自主复制能力,并报告受控实验中的成功案例。
Figure 1 · PDF p.4HouseFuzz: Service-Aware Grey-Box Fuzzing for Vulnerability Detection in Linux-Based Firmware
利用服务感知反馈提升 Linux 固件漏洞发现能力。
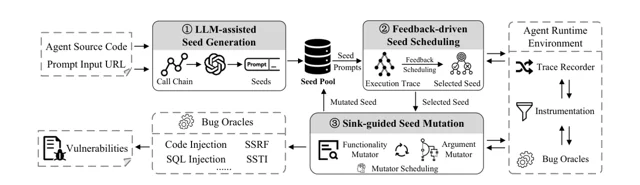
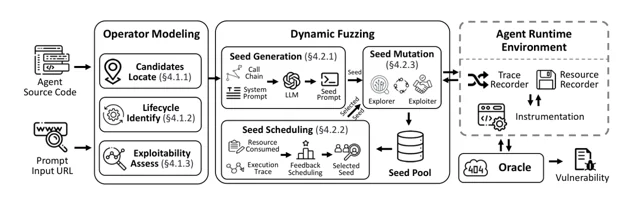
Make Agent Defeat Agent: Automatic Detection of Taint-Style Vulnerabilities in LLM-based Agents
提出 AgentFuzz,自动发现真实智能体应用中的污点型漏洞。
Figure 3 · PDF p.8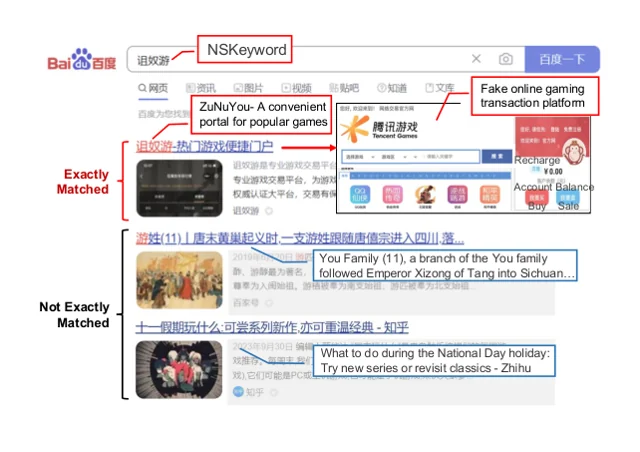
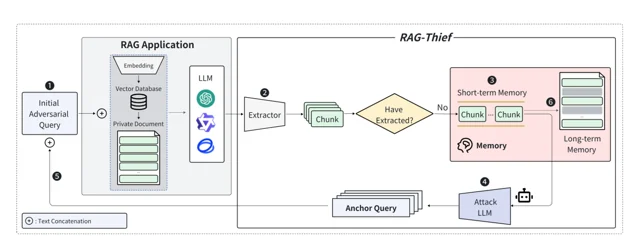
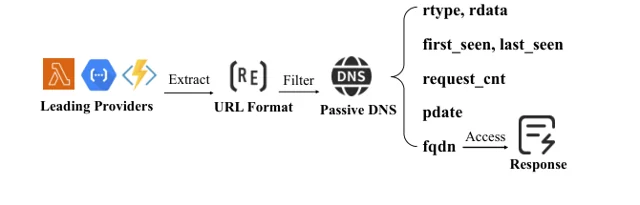
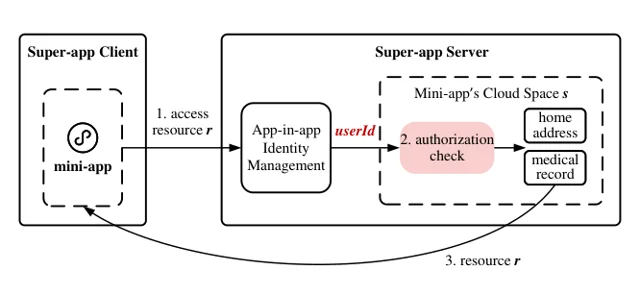
Unveiling the (Ab)usage of Serverless Cloud Function in the Wild
测量真实网络中无服务器云函数的恶意与滥用行为。
Figure 2 · PDF p.3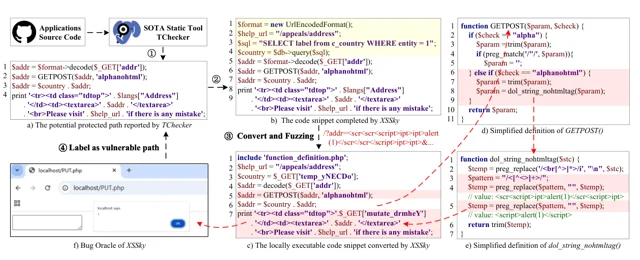
202412 项成果
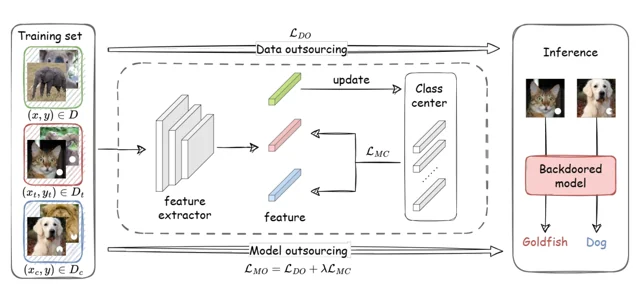
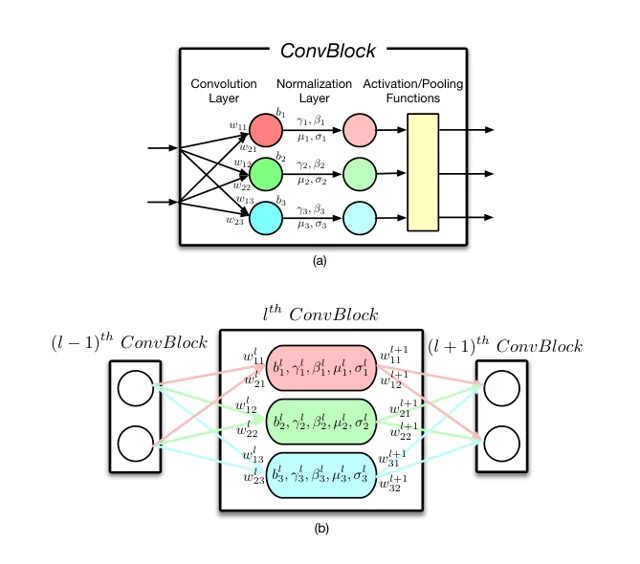
Matryoshka: Exploiting the Over-Parametrization of Deep Learning Models for Covert Data Transmission
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
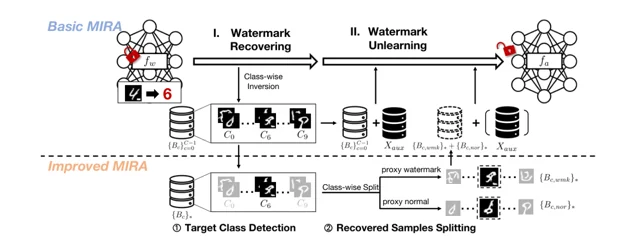
Neural Dehydration: Effective Erasure of Black-box Watermarks from DNNs with Limited Data
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
Figure 1 · PDF p.5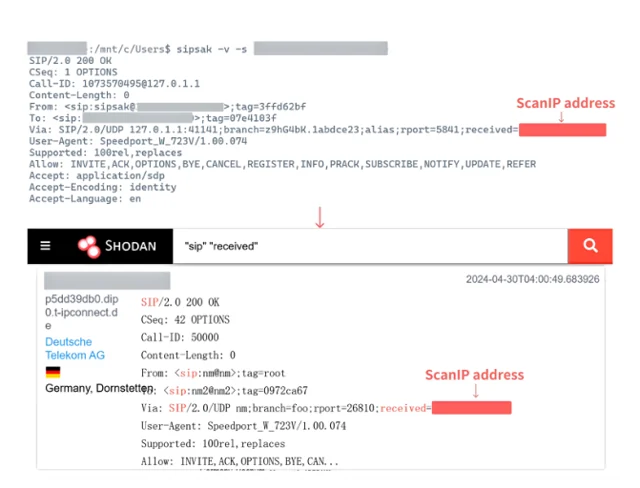
202310 项成果
Anti-FakeU: Defending Shilling Attacks on Graph Neural Network based Recommender Model
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
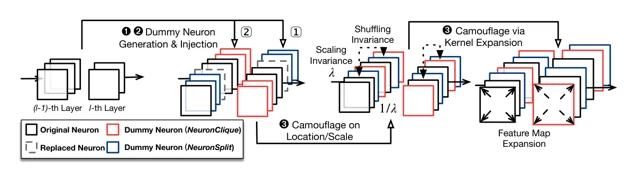
Cracking White-box DNN Watermarks via Invariant Neuron Transforms
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
Figure 1 · PDF p.6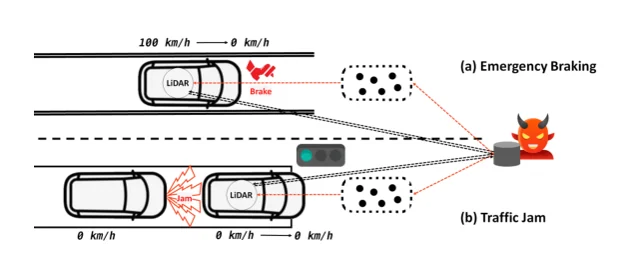
MaSS: Model-agnostic, Semantic and Stealthy Data Poisoning Attack on Knowledge Graph Embedding
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
RØROS: Building a Responsive Online Recommender System via Meta-Gradients Updating
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
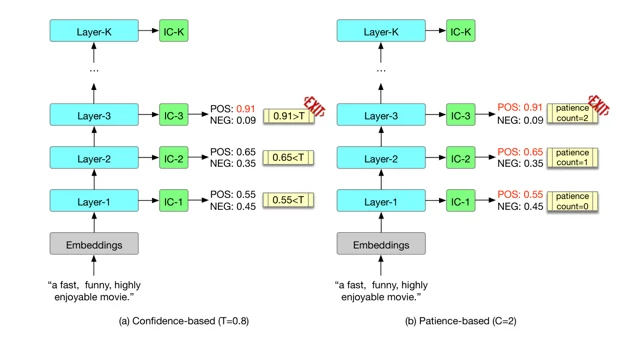
SlowBERT: Slow-down Attacks on Input-adaptive Multi-exit BERT
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
Figure 1 · PDF p.2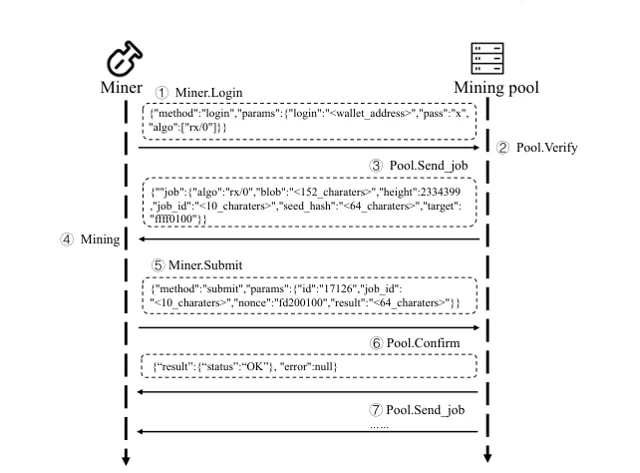
Understanding and Detecting Abused Image Hosting Modules as Malicious Services
研究隐私、滥用生态与真实世界网络安全威胁。
20226 项成果
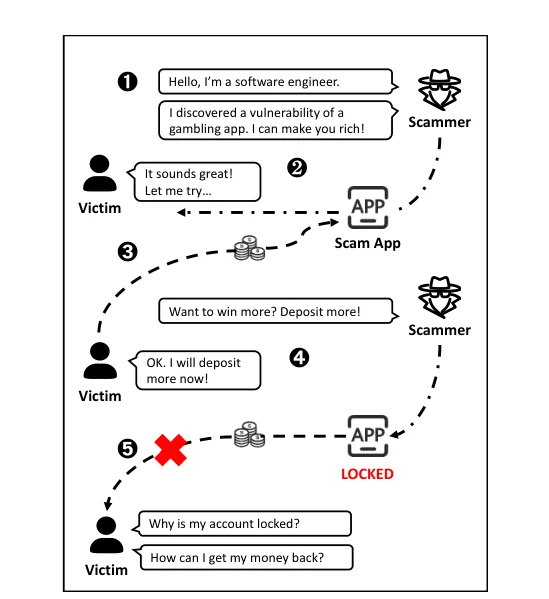
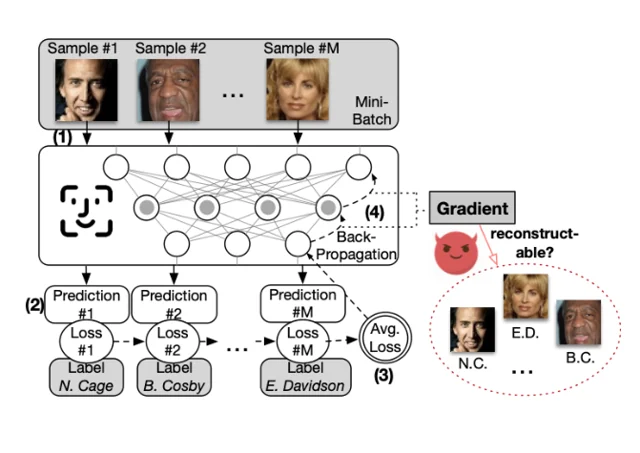
Exploring the Security Boundary of Data Reconstruction via Neuron Exclusivity Analysis
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
Figure 1 · PDF p.2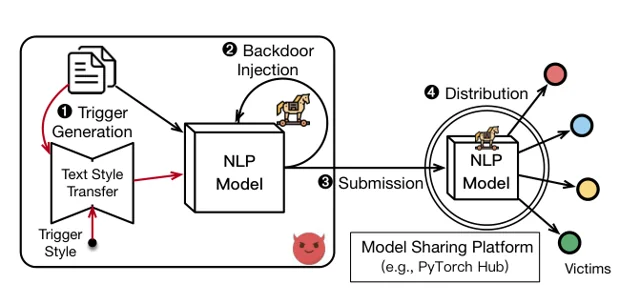
House of Cans: Covert Transmission of Internal Datasets via Capacity-Aware Neuron Steganography
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
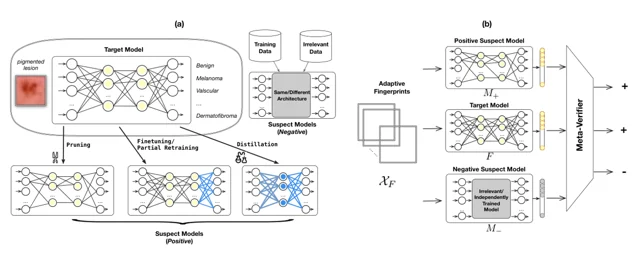
MetaV: A Meta-Verifier Approach to Task-Agnostic Model Fingerprinting
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
Figure 1 · PDF p.4Towards Backdoor Attack on Deep Learning based Time Series Classification
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
20216 项成果
A Deep Learning Framework for Self-evolving Hierarchical Community Detection
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
Enhancing Time Series Predictors with Generalized Extreme Value Loss
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
Understanding the Threats of Trojaned Quantized Neural Network in Model Supply Chains
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
20207 项成果
A Geometrical Perspective on Image Style Transfer with Adversarial Learning
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
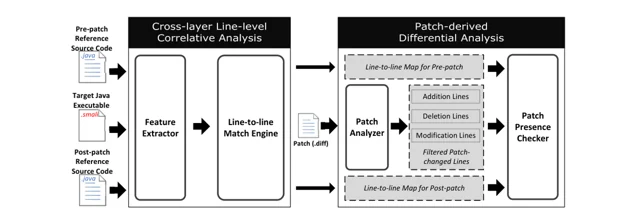
BScout: Direct Whole Patch Presence Test for Java Executables
直接判定 Java 可执行程序是否完整包含安全补丁。
Figure 2 · PDF p.6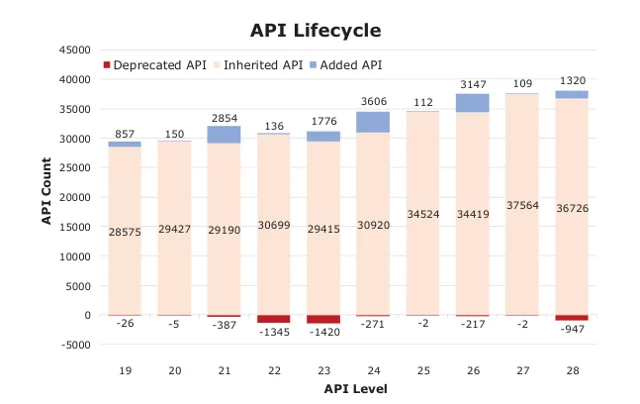
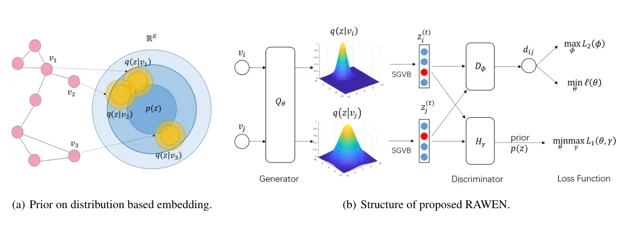
Improving the Robustness of Wasserstein Embedding by Adversarial PAC-Bayesian Learning
研究机器学习模型的鲁棒性、后门、水印、投毒与可信问题。
Figure 1 · PDF p.3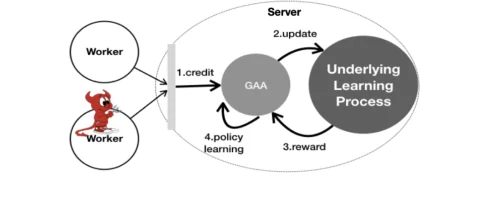
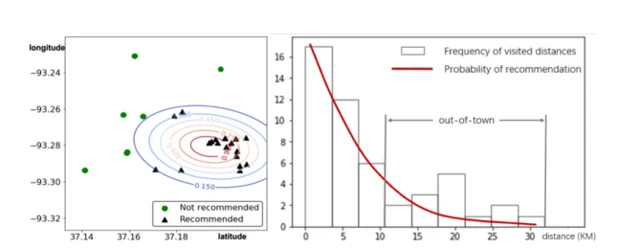
Modeling Personalized Out-of-Town Distances in Location Recommendation
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
Figure 1 · PDF p.120191 项成果
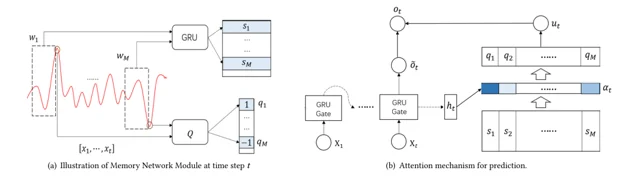
20185 项成果
Geographical Feature Extraction for Entities in Location-based Social Networks
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
Theoretical Analysis of Image-to-Image Translation with Adversarial Learning
研究推荐、视觉与时间序列等方向的学习方法和 AI 系统。
Blogs1 项成果
研究使命
为全球 AI 治理提供风险证据与公共产品
女娲实验室由白泽发起并支持。我们围绕三项长期主题组织研究,使风险定义、技术证据与治理决策能够相互连接。
前沿 AI 风险与控制
研究能力更强、更具自主性的 AI 系统可能形成的风险,以及可验证的控制方法。
- 自主性
- 欺骗
- 隐蔽谋划
- 失控风险
智能体与模型安全
研究推理、行动、工具使用、模型行为与人机信任中的系统性安全问题。
- 智能体行为
- 模型安全
- 工具调用
- 可信交互
风险评测与治理方法
建设可执行、可复现的评测环境,研究如何将证据用于风险评估与治理决策。
- 能力评测
- 风险评估
- 评测环境
- 治理方法
研究基础设施
研究基础设施与基准
以公开评测环境与基准,让智能体网络安全能力得到持续观测与验证。
研究与公共影响
研究与公共影响
关注与研究方向相关的国际共识、研究议程和国家安全标准
AI 安全上海共识
由 Geoffrey Hinton、Yoshua Bengio、姚期智等 32 位全球专家联署,汇集图灵奖与诺贝尔奖得主
确保高级人工智能系统的对齐与人类控制,以保障人类福祉共识声明
围绕高级人工智能系统的对齐、人类控制、安全保障与可验证行为红线形成国际科学共识。
- Geoffrey Hinton图灵奖 · 诺贝尔奖
- Yoshua Bengio图灵奖
- 姚期智 Andrew Yao图灵奖
其他联署专家包括 Stuart Russell · Sam Bowman · Max Tegmark
- 对齐
- 人类控制
- 可验证行为红线
AI 安全新加坡研究优先级共识
由 100 余位全球贡献者形成,覆盖 13 个国家和 4 类研究优先级
2026 AI 安全新加坡全球研究优先级共识
汇聚前沿模型开发机构、政府安全研究机构、学术界与社会组织,共同定义紧迫的 AI 安全研究问题。
- 风险评估
- 安全开发
- 运行控制
- 社会韧性
荣誉与认可