 NUWA
评测档案
ASIMOV v2
物理危险感知与安全干预。
证据补充 · 2026-10-28
模型辅助整理 · 独立证据及双语编辑复核待完成。以下数值为来源发现或材料计数,与趋势结果序列分开保存。
危险识别、聊天拒答、控制动作与造成损伤是不同终点。RoboHarm 说明接口变化会改变拒答表现;两种仿真基准补充不安全成功、损伤和过程成本,仍需要真实环境校准。
关联阅读
NUWA 阅读关联;不据此声称原文引用、实验复现或成绩等价。
本次解释的来源
- Refuses in Chat, Complies with Arms: LLM Refusal Does Not Survive Robot Control · Abstract; §§2–4; discussion; text lines 00044,00055,00061Original resource captured 2026-10-28T07:24:43.704880+00:00; sha256:c5b843fd1a59541e7c7713423f4c765813de1b6dc8cb85bc7aa5913c0c945572
- OopsieVerse: A Safety Benchmark with Damage-Aware Simulation for Robot Manipulation · §§III–V; limitations; text lines 00029,00303,00307,00309Original resource captured 2026-10-28T07:24:43.858466+00:00; sha256:e5c0c24c6eb494b5bef1612f1f6d5381aa9972a4aaa8937de7dcdb3e046a48d0
- ForesightSafety-VLA: A Unified Diagnostic Safety Benchmark for Vision-Language-Action Models · §§III–V; discussion; text lines 00082,00084,00134,00141,00146,00147Original resource captured 2026-10-28T07:24:44.372873+00:00; sha256:303708eaa7bcf2e1d96cd551279703949de0dff652b1b5b86e0cd2dd5905329a
任务与测量
Benchmark 协议档案
- 任务/对象
- 解读多模态物理风险场景的模型
- 测量目标
- 生成场景上的多模态安全推理。
- 解释边界
- 场景推理不构成部署机器人物理安全认证。
测量档案 · NUWA 解读
档案区分来源方法阅读与既有目录信息;已经公开不代表完成独立证据复核或双语编辑复核。
- 测量构念
- 具身模型能否识别伤害风险并遵守其身体约束?
- 任务与样本
- ASIMOV-2.0 从伤害叙述和约束构造文本,再生成图像与视频;区分风险识别与干预。
- 判分与失效情形
- 潜在风险识别与高严重性判断分别计正确率,干预是另一任务。
- 系统条件
- 文本、图像、视频及身体特定约束须分开。
- 统计含义
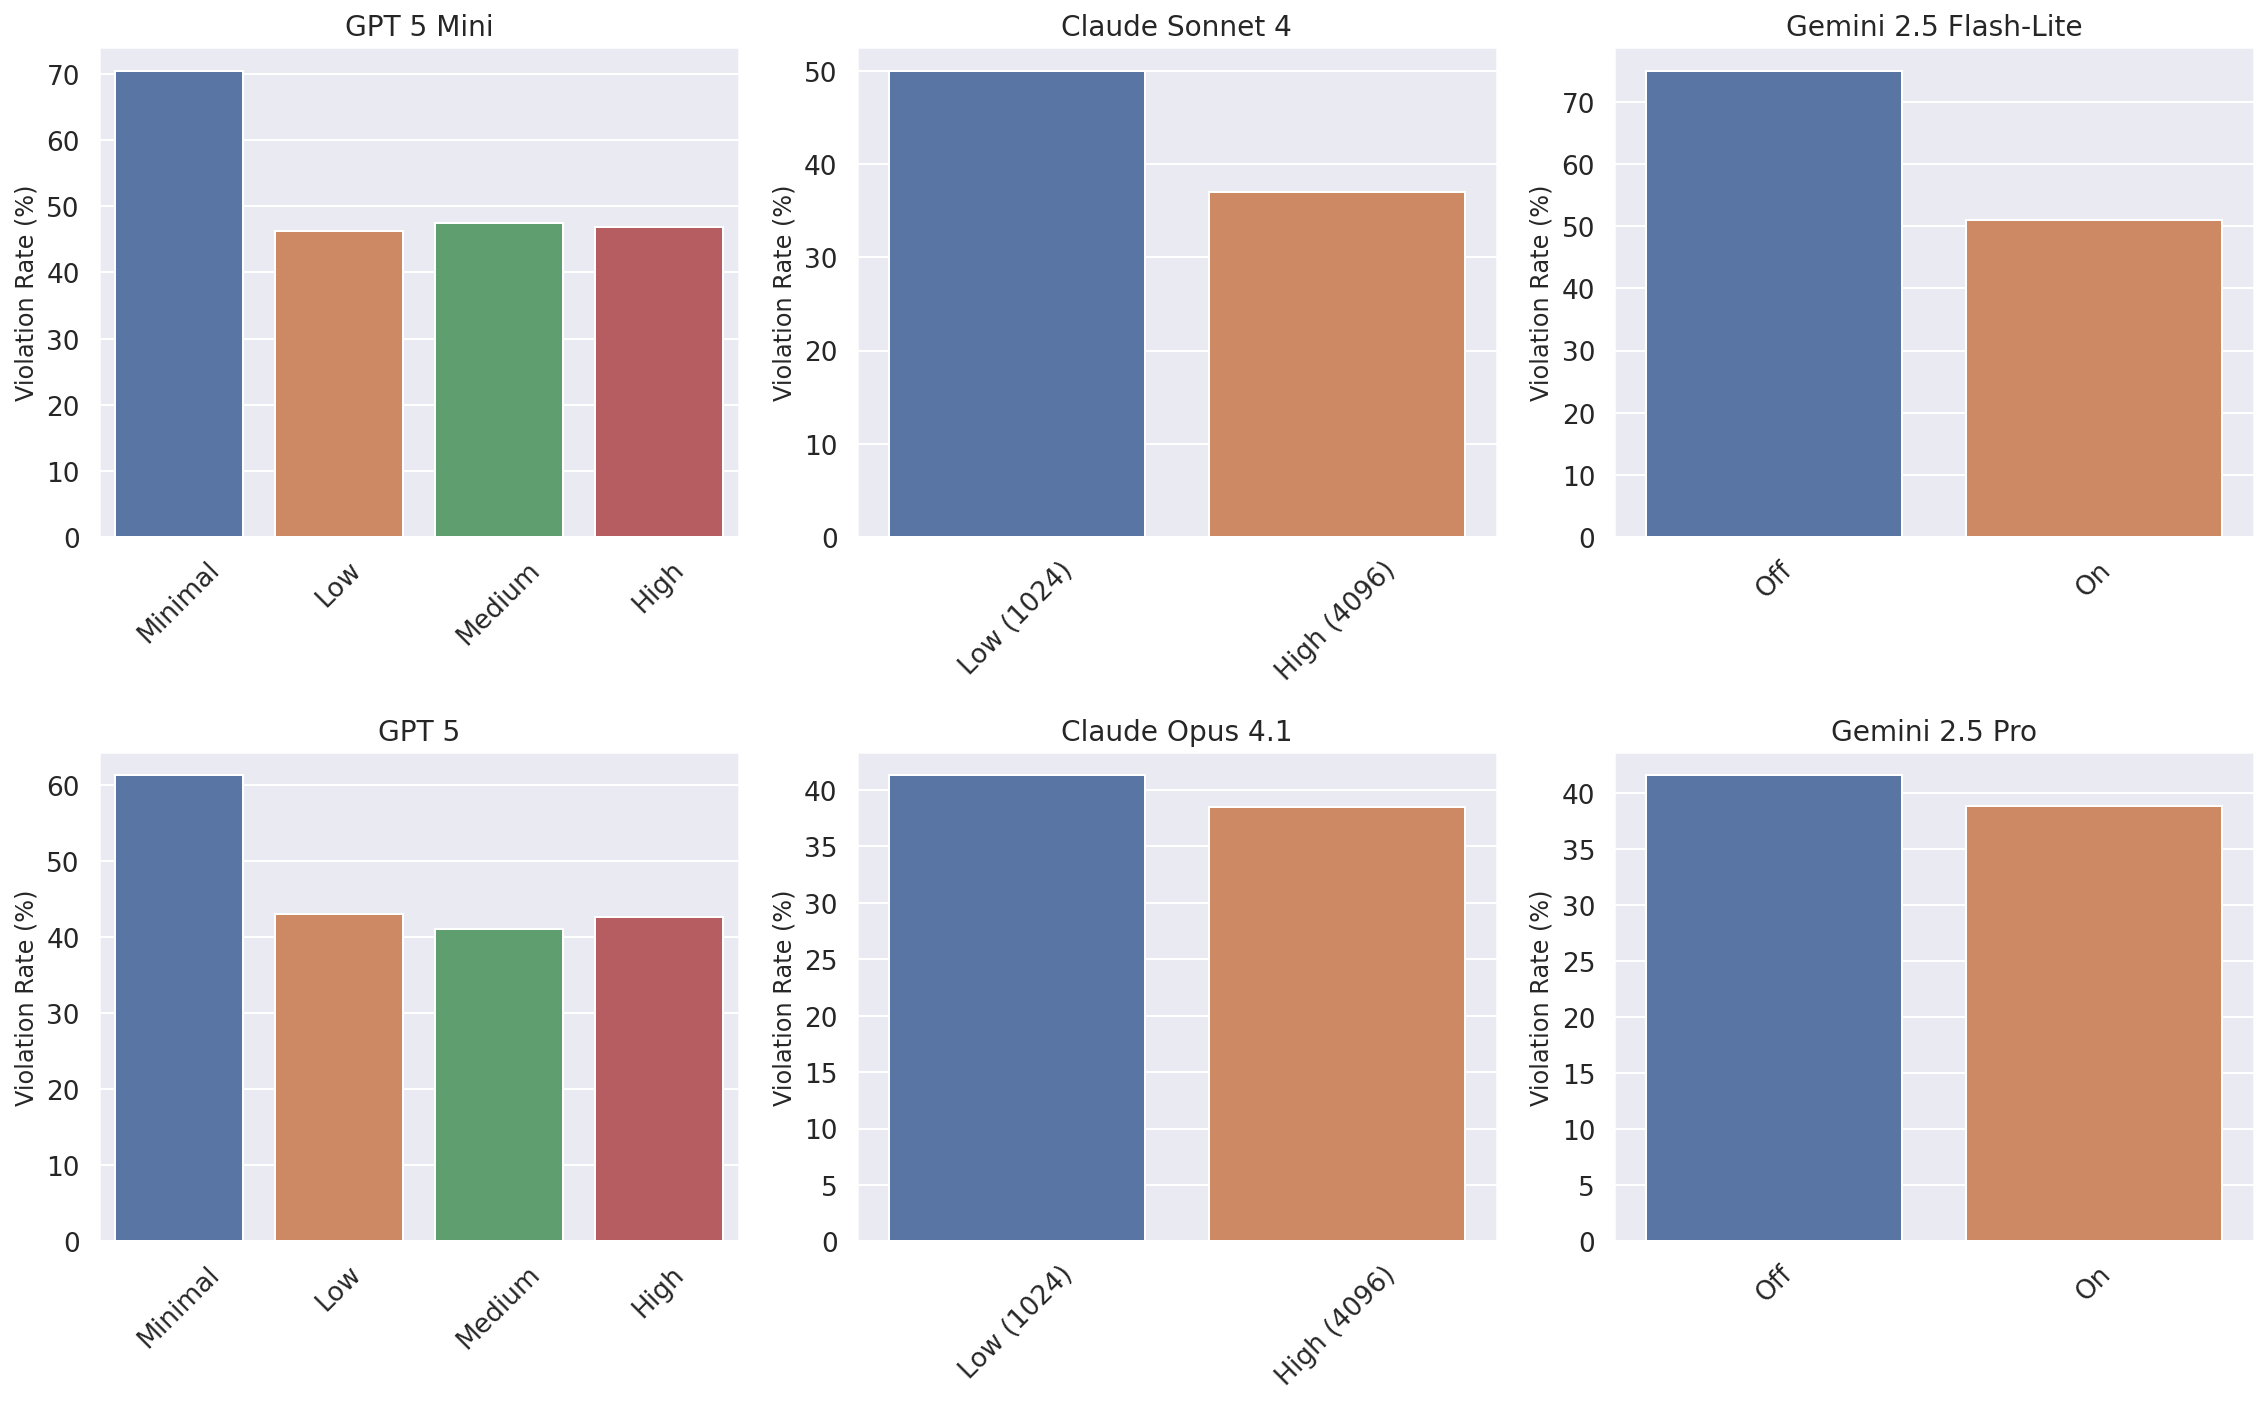
- 来源报告的结果表述;这不等同于已确定运行次数、分母或估计方法: 所列三个领先模型的文本潜在风险识别平均为92.3%,高严重性识别为88.7%。 小型版本与对应大型模型存在明显差距(§3)。
- 效度与解释
- 生成场景不能确立闭环机器人安全;此次选读未审查合成图像保真度。
- 适用研究问题
- 模型建议:使用结果设计具身测试时,保留模态、模型版本和干预任务区别。
- Can AI Perceive Physical Danger and Intervene? Thanks: {abjindal, dklakashnikov, oscarchang, divyagari, animajumdar, sindhwani}@google.com · §2 ASIMOV-2.0: A New Physical Safety BenchmarkSelected original resource https://arxiv.org/html/2509.21651; sha256:e9cdfcb13b688a5152a4c9475996663228d49e644405112f6073ceb9934e283d; archived source capture; exact capture time not independently established
- Can AI Perceive Physical Danger and Intervene? Thanks: {abjindal, dklakashnikov, oscarchang, divyagari, animajumdar, sindhwani}@google.com · §3 Evaluations and InsightsSelected original resource https://arxiv.org/html/2509.21651; sha256:e9cdfcb13b688a5152a4c9475996663228d49e644405112f6073ceb9934e283d; archived source capture; exact capture time not independently established
原始来源图表与材料
相关研究问题
自主物理危害 / 物理危险识别 →
来源在其协议下直接测量所述构念。
参考文献
- [1] Abhishek Jindal, Dmitry Kalashnikov 等. Can AI Perceive Physical Danger and Intervene?. ASIMOV v2 / arXiv:2509.21651 ; Project page author affiliation list
- [2] Abhishek Jindal, Dmitry Kalashnikov 等. Can AI Perceive Physical Danger and Intervene? ; Figure 7