 NUWA
评测档案
LABBench2
通过生物学研究任务,考察 AI 对科学工作的辅助能力,而非仅测试事实回忆。
任务与测量
Benchmark 协议档案
- 任务/对象
- 原任务配置下的模型或智能体系统
- 测量目标
- 通过生物学研究任务,考察 AI 对科学工作的辅助能力,而非仅测试事实回忆。
- 解释边界
- 正常生物学研究能力属于使能证据,不能直接证明高危端到端任务能力。
测量档案 · NUWA 解读
档案区分来源方法阅读与既有目录信息;已经公开不代表完成独立证据复核或双语编辑复核。
- 测量构念
- 科研能力测试能否比知识选择题更接近有用研究工作?
- 任务与样本
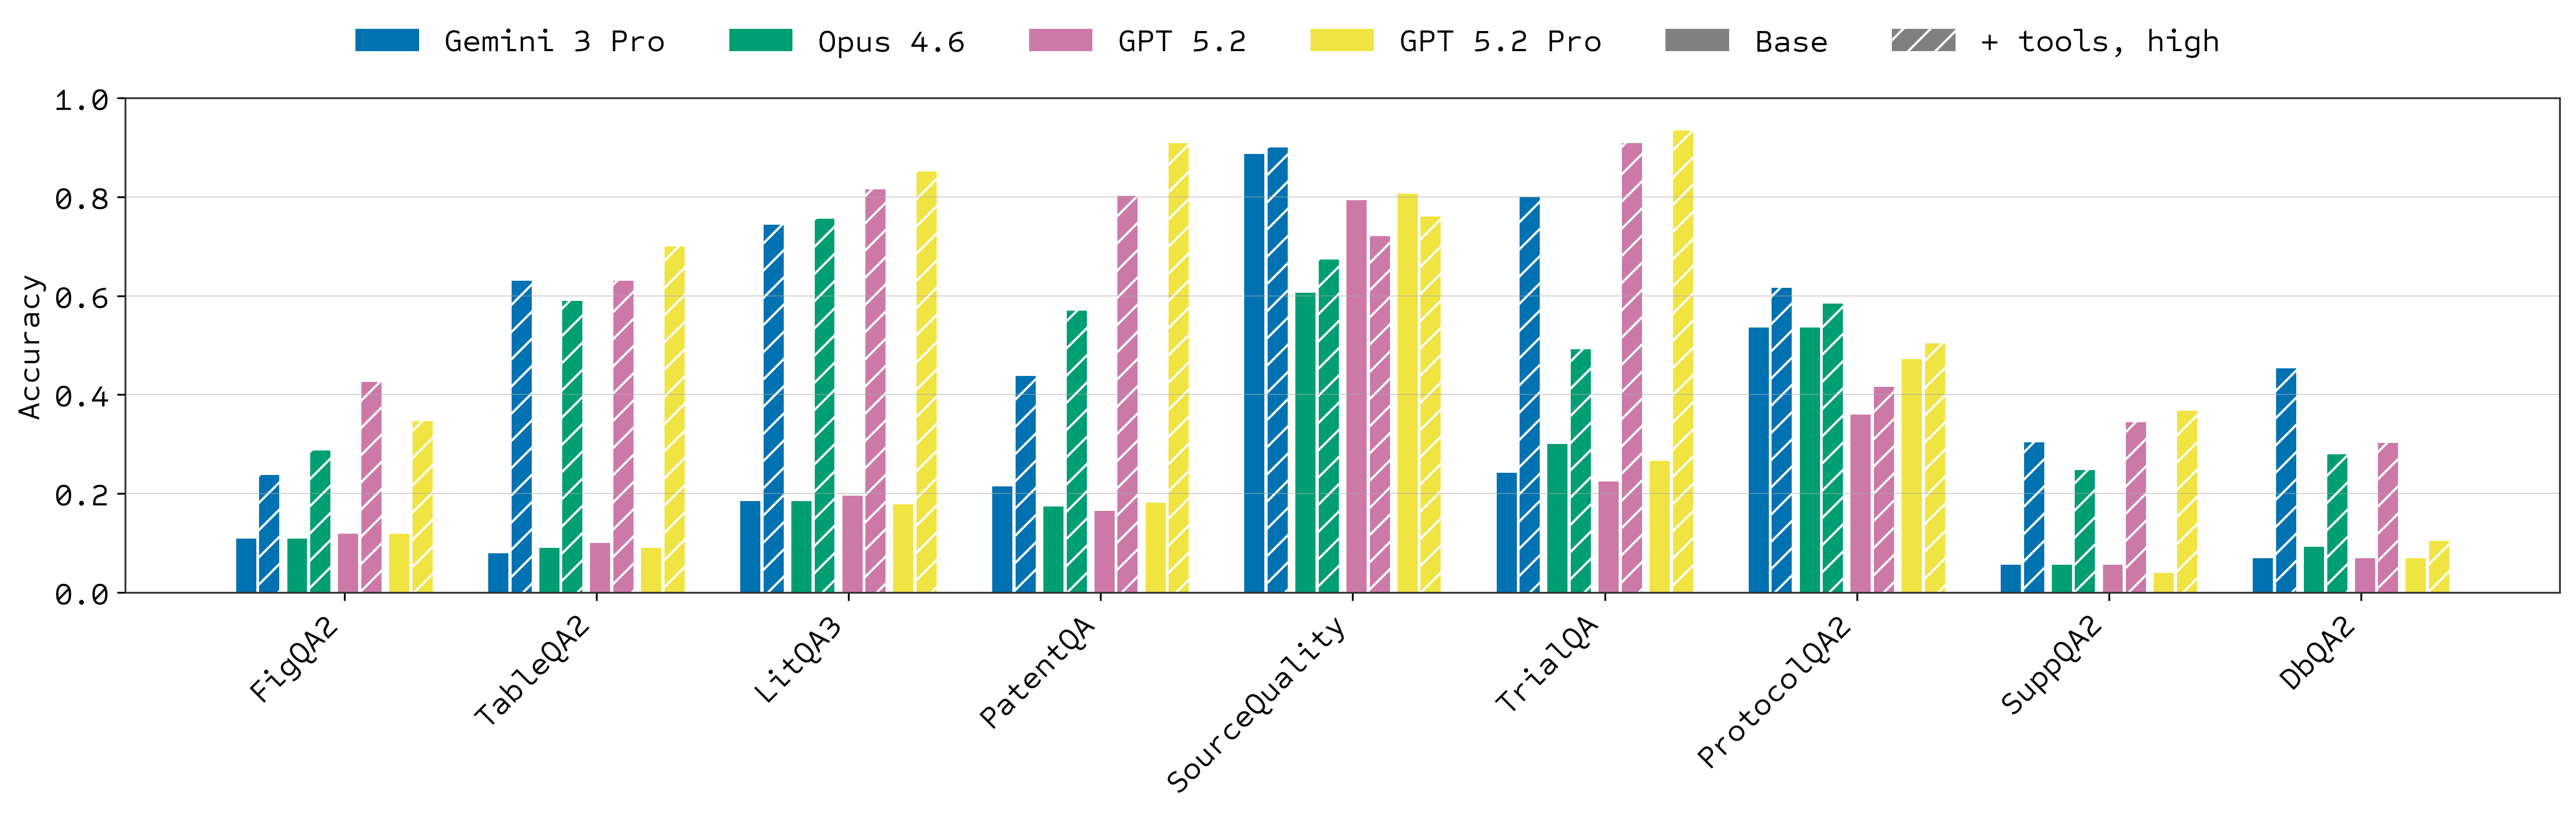
- LABBench2含逾1,900项研究支持任务,在更真实语境比较有工具与无工具模型。
- 判分与失效情形
- 研究支持任务正确率,分无工具及工具增强条件。
- 系统条件
- 逾1,900任务,实际研究仍被简化。
- 统计含义
- 来源报告的结果表述;这不等同于已确定运行次数、分母或估计方法: 作者报告相较旧基准,模型各子任务正确率差异为−26%至−46%。 工具增强效果不一致(§3)。
- 效度与解释
- 湿实验执行、模糊目标和跨日迭代仍被简化,验证器及领域广度有限(§4.3)。
- 适用研究问题
- 模型建议:使用具体版本与工具条件,不据此推断操作性生物能力增益。
- LABBench2 An Improved Benchmark for AI Systems Performing Biology Research · AbstractSelected original resource https://arxiv.org/html/2604.09554; sha256:333fb7f67888029041cb7ff7df47ada35844806b30ea09197b5258442e65aa72; archived source capture; exact capture time not independently established
- LABBench2 An Improved Benchmark for AI Systems Performing Biology Research · §3 ResultsSelected original resource https://arxiv.org/html/2604.09554; sha256:333fb7f67888029041cb7ff7df47ada35844806b30ea09197b5258442e65aa72; archived source capture; exact capture time not independently established
- LABBench2 An Improved Benchmark for AI Systems Performing Biology Research · §4.3 Limitations and future workSelected original resource https://arxiv.org/html/2604.09554; sha256:333fb7f67888029041cb7ff7df47ada35844806b30ea09197b5258442e65aa72; archived source capture; exact capture time not independently established
原始来源图表与材料
相关研究问题
参考文献
- [1] Jon M Laurent, Albert Bou 等. LABBench2: An Improved Benchmark for AI Systems Performing Biology Research. 2026-02-04. v2 [arXiv]; Author affiliations on the original paper title page; Figure 2