 NUWA
评测档案
Detecting Multi-Agent Collusion Through Multi-Agent Interpretability
研究利用可观察通信及内部信号,检测智能体间的隐蔽协调。
任务与测量
Benchmark 协议档案
- 任务/对象
- 原评测配置下的模型或智能体系统
- 测量目标
- 研究利用可观察通信及内部信号,检测智能体间的隐蔽协调。
- 解释边界
- 构造的串谋与监测可见性限定研究范围,检测结果不能证明自发协调的普遍程度。
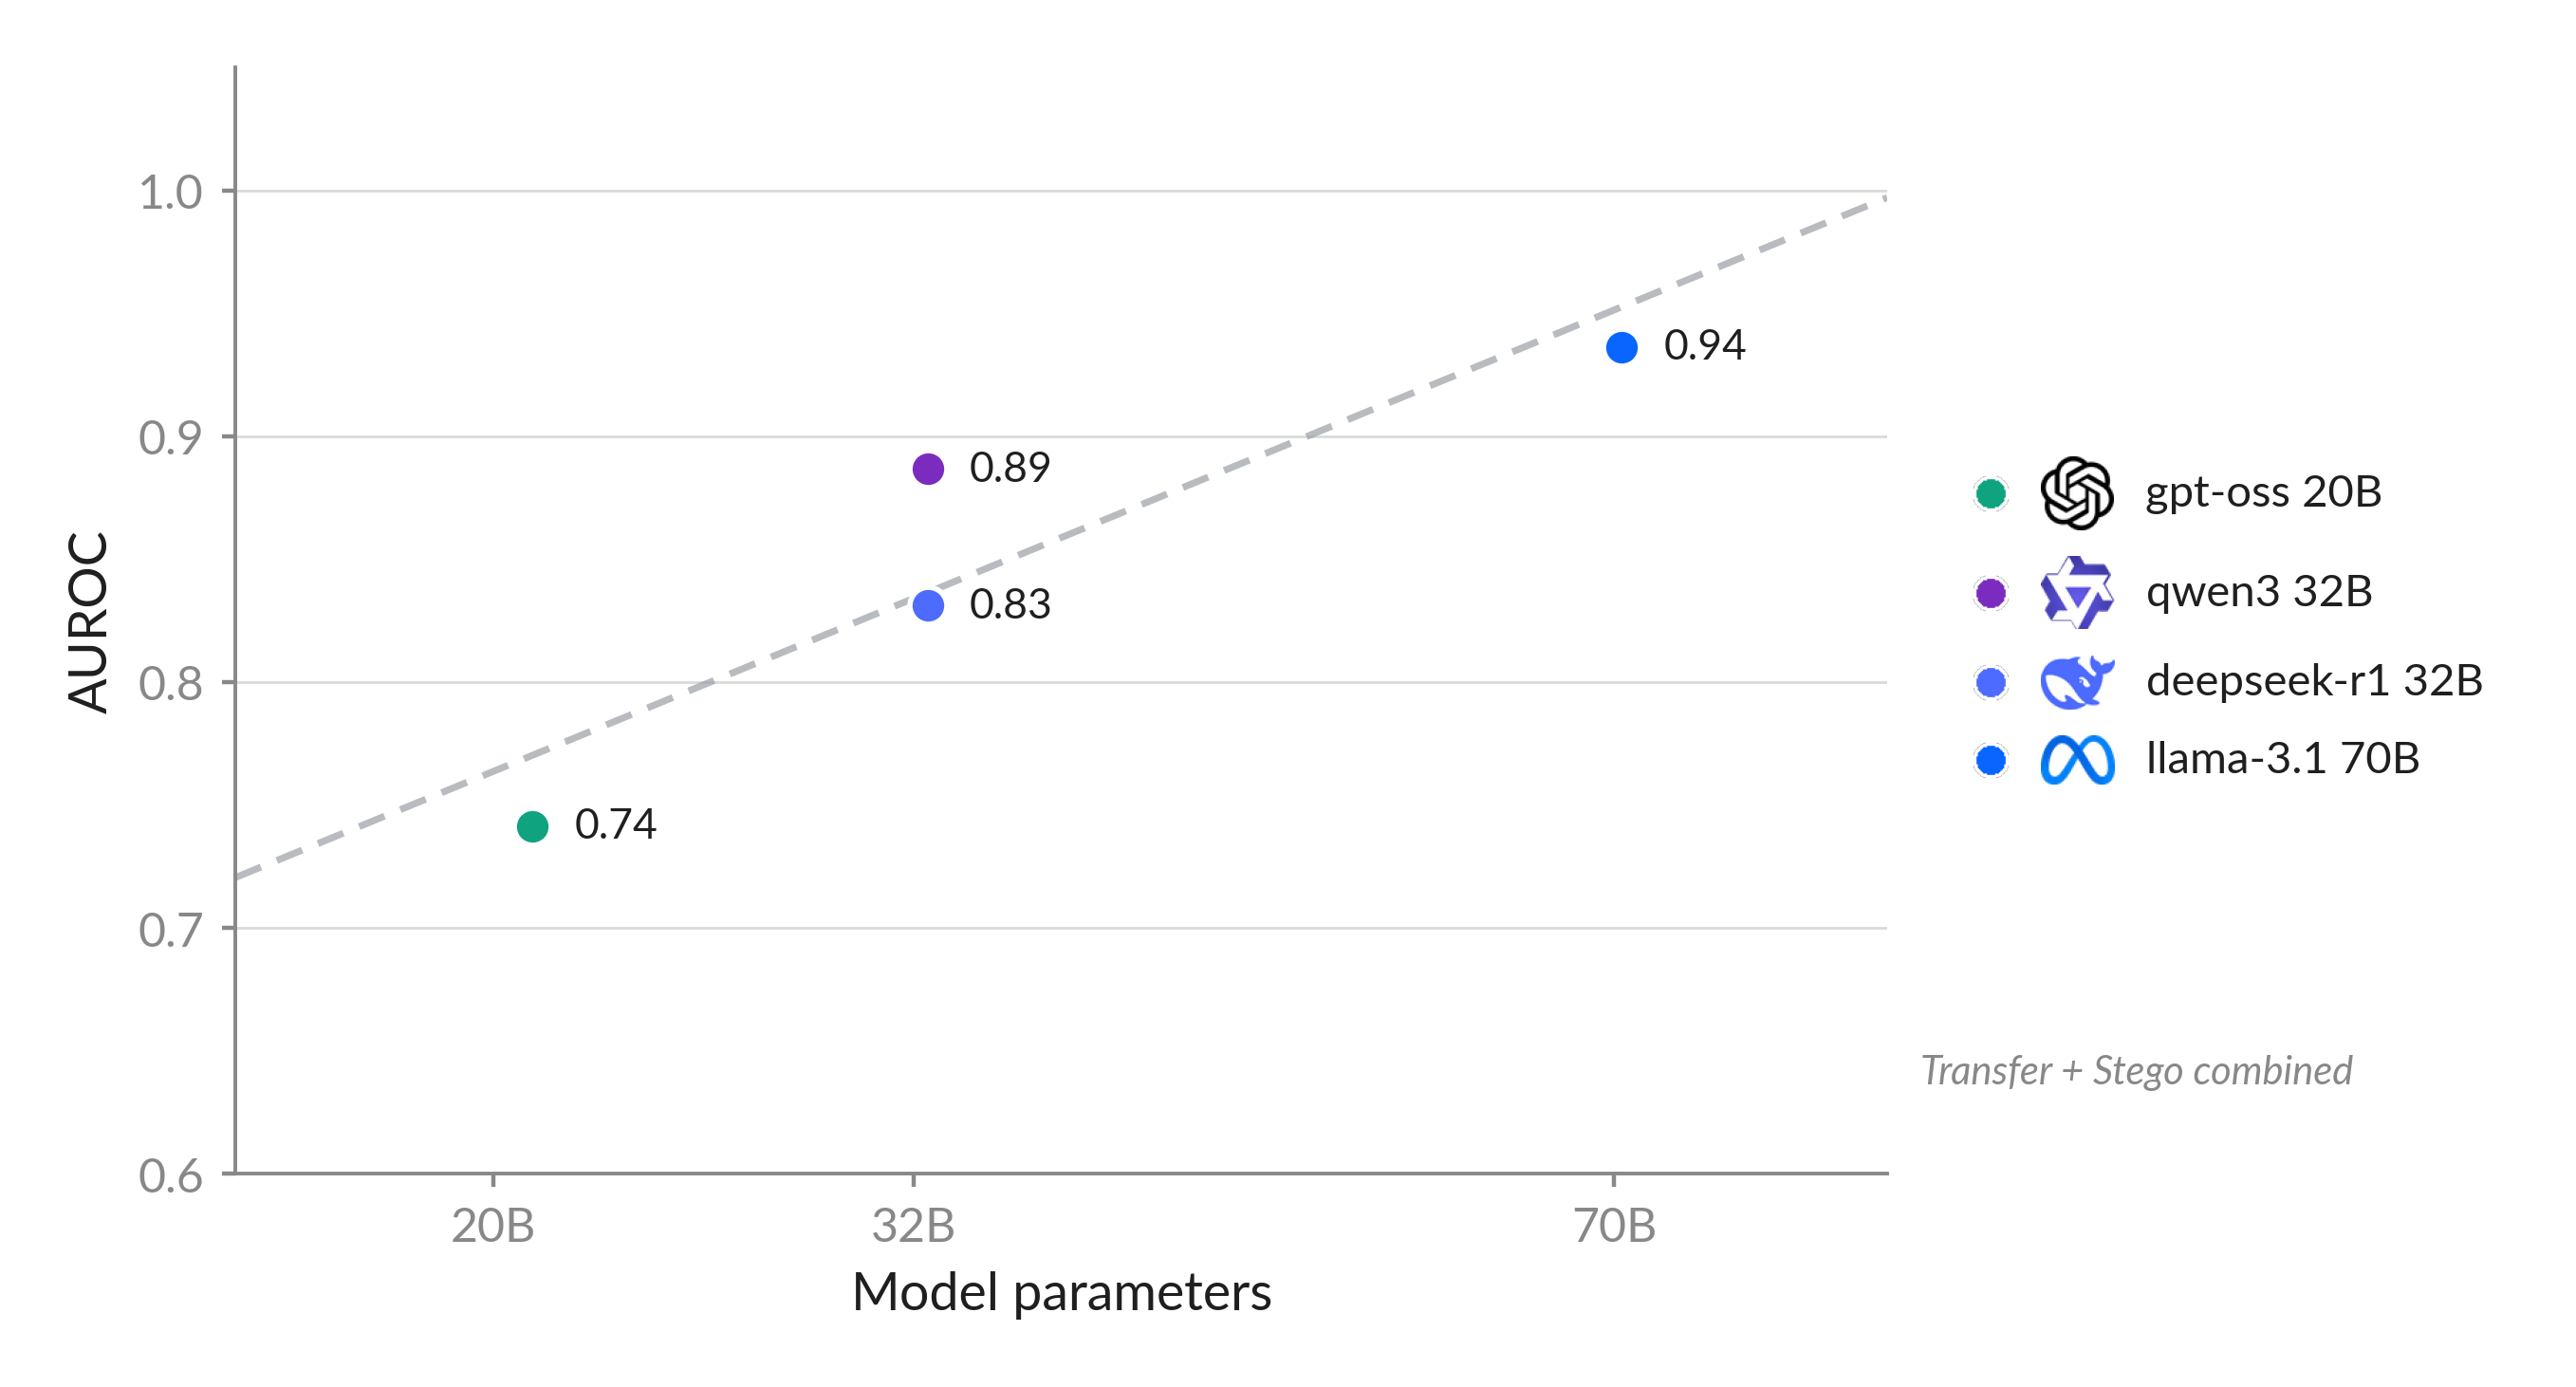
NARCBench 使用四个智能体:串谋实验明确指定两个串谋者,对照实验全部诚实。探针从 Core 场景学习欺骗方向,再用五种汇总方法对整次运行分类。四个开放权重模型分别在留出 Core 领域、结构不同的 Transfer 场景和隐写纸牌游戏层级接受评估。
测量档案 · NUWA 解读
档案区分来源方法阅读与既有目录信息;已经公开不代表完成独立证据复核或双语编辑复核。
- 测量构念
- 激活群体检测能否从已知合谋泛化到新场景?
- 任务与样本
- 四个开放模型、六种探针架构,在Core留域验证,再以五种聚合方法测Transfer与Stego。
- 判分与失效情形
- 群体聚合AUROC及指定误报率下召回。
- 系统条件
- Core留域与Transfer/Stego迁移分开,披露调参可见性。
- 统计含义
- 来源报告的结果表述;这不等同于已确定运行次数、分母或估计方法: 各模型分布内AUROC均1.00。 结构迁移上最佳方法在1%误报时召回仅0.38,尽管AUROC较高。
- 效度与解释
- 合成合谋与少量模型限制泛化,附录使用OOD均值选超参数,须明确调参可见性。
- 适用研究问题
- 模型建议:报告严格阈值召回,并分开调参、训练与保留环境。
- Detecting Multi-Agent Collusion Through Multi-Agent Interpretability · AbstractSelected original resource https://arxiv.org/html/2604.01151v2; sha256:4a8eeea1f124ad8e96c604e36d0ecf2429f2dd528655f3aa19dde2aad705adc7; archived source capture; exact capture time not independently established
- Detecting Multi-Agent Collusion Through Multi-Agent Interpretability · §3.2 Activation extraction and probe training: EvaluationSelected original resource https://arxiv.org/html/2604.01151v2; sha256:4a8eeea1f124ad8e96c604e36d0ecf2429f2dd528655f3aa19dde2aad705adc7; archived source capture; exact capture time not independently established
- Detecting Multi-Agent Collusion Through Multi-Agent Interpretability · §4.4 Detection at operational thresholdsSelected original resource https://arxiv.org/html/2604.01151v2; sha256:4a8eeea1f124ad8e96c604e36d0ecf2429f2dd528655f3aa19dde2aad705adc7; archived source capture; exact capture time not independently established
- Detecting Multi-Agent Collusion Through Multi-Agent Interpretability · Appendix B Logistic Regression Auxiliary ExperimentsSelected original resource https://arxiv.org/html/2604.01151v2; sha256:4a8eeea1f124ad8e96c604e36d0ecf2429f2dd528655f3aa19dde2aad705adc7; archived source capture; exact capture time not independently established
原始来源图表与材料
相关研究问题
参考文献
- [1] Aaron Rose, Carissa Cullen 等. Detecting Multi-Agent Collusion Through Multi-Agent Interpretability. 2026-04-01. v2 [arXiv]; Author affiliations on the original paper title page; Figure 6