 NUWA
评测档案
Situational Awareness Dataset (SAD)
测量自我知识与情境意识的多任务基准。
跨报告监测
已发表证据
Situational Awareness Dataset (SAD) · Facts-LLMs
跨来源报告的已发表测量。任务范围通过注释区分,配置差异保留在每条观测中。
6 条观测 · 0 已定位日期
● 条件匹配◇ 配置差异□ 部分条件未披露
6 条观测尚无已核实的模型发布日期,可在数据与系统结果中查看。
选择图中数据点或表格行,查看条件与出处。
6 条观测
| 系统/模型 | 结果 | 条件状态 | 任务/条件 | 评测方/报告 | 日期 |
|---|---|---|---|---|---|
 Muse Spark | 96.4%Facts-LLMs95% CI (bootstrap); reported ±2.2; 1000 resamples | 条件不完整 | SAD-miniFacts-LLMs— | 未披露Evaluating DeepSeek v4 Pro for Frontier Risks | 发布 —报告 2026-05-29 |
 Gemini 3.1 Pro | 96%Facts-LLMs95% CI (bootstrap); reported ±2.4; 1000 resamples | 条件不完整 | SAD-miniFacts-LLMs— | 未披露Evaluating DeepSeek v4 Pro for Frontier Risks | 发布 —报告 2026-05-29 |
 DeepSeek v4 Pro | 95.4%Facts-LLMs95% CI (bootstrap); reported ±2.5; 1000 resamples | 条件不完整 | SAD-miniFacts-LLMs— | 未披露Evaluating DeepSeek v4 Pro for Frontier Risks | 发布 —报告 2026-05-29 |
 Kimi K2.5 | 95.2%Facts-LLMs95% CI (bootstrap); reported ±2.6; 1000 resamples | 条件不完整 | SAD-miniFacts-LLMs— | 未披露Evaluating DeepSeek v4 Pro for Frontier Risks | 发布 —报告 2026-05-29 |
 GPT-5.4 | 94%Facts-LLMs95% CI (bootstrap); reported ±3.0; 1000 resamples | 条件不完整 | SAD-miniFacts-LLMs— | 未披露Evaluating DeepSeek v4 Pro for Frontier Risks | 发布 —报告 2026-05-29 |
 Claude Opus 4.6 | 92.8%Facts-LLMs95% CI (bootstrap); reported ±3.0; 1000 resamples | 条件不完整 | SAD-miniFacts-LLMs— | 未披露Evaluating DeepSeek v4 Pro for Frontier Risks | 发布 —报告 2026-05-29 |
结合任务范围与运行配置解读结果。
METR Time Horizon 1.1 来源已停止积极更新,最后更新于 2026 年 9 月 8 日。超过 16 小时的估计超出其可靠测量范围。
协议、配置与原始证据 →任务与测量
Benchmark 协议档案
- 任务/对象
- 回答情境意识任务的语言模型
- 测量目标
- 模型识别自身、所处环境及可影响范围的任务准确率。
- 评分/结果口径
- Facts-LLMs · 记录配置下的来源报告指标。
- 解释边界
- 情境意识可能是评测规避的前提,不证明规避行为已经发生。
一项已报告评测
来源评测 DeepSeek v4 Pro · SAD-mini.
报告指标: Facts-LLMs · 95.4%.
记录配置下的来源报告指标。 来源分母:249(单位未披露)
Facts-LLMs:95.4 percent;保留来源条件。
测量档案 · NUWA 解读
档案区分来源方法阅读与既有目录信息;已经公开不代表完成独立证据复核或双语编辑复核。
- 测量构念
- 模型在行为上能展示哪些关于自身及处境的知识?
- 任务与样本
- SAD 含七类13,198题,使用选择或自由回答以及字符串或模型判分。
- 判分与失效情形
- 七类任务分别按选择、字符串或模型判分。
- 系统条件
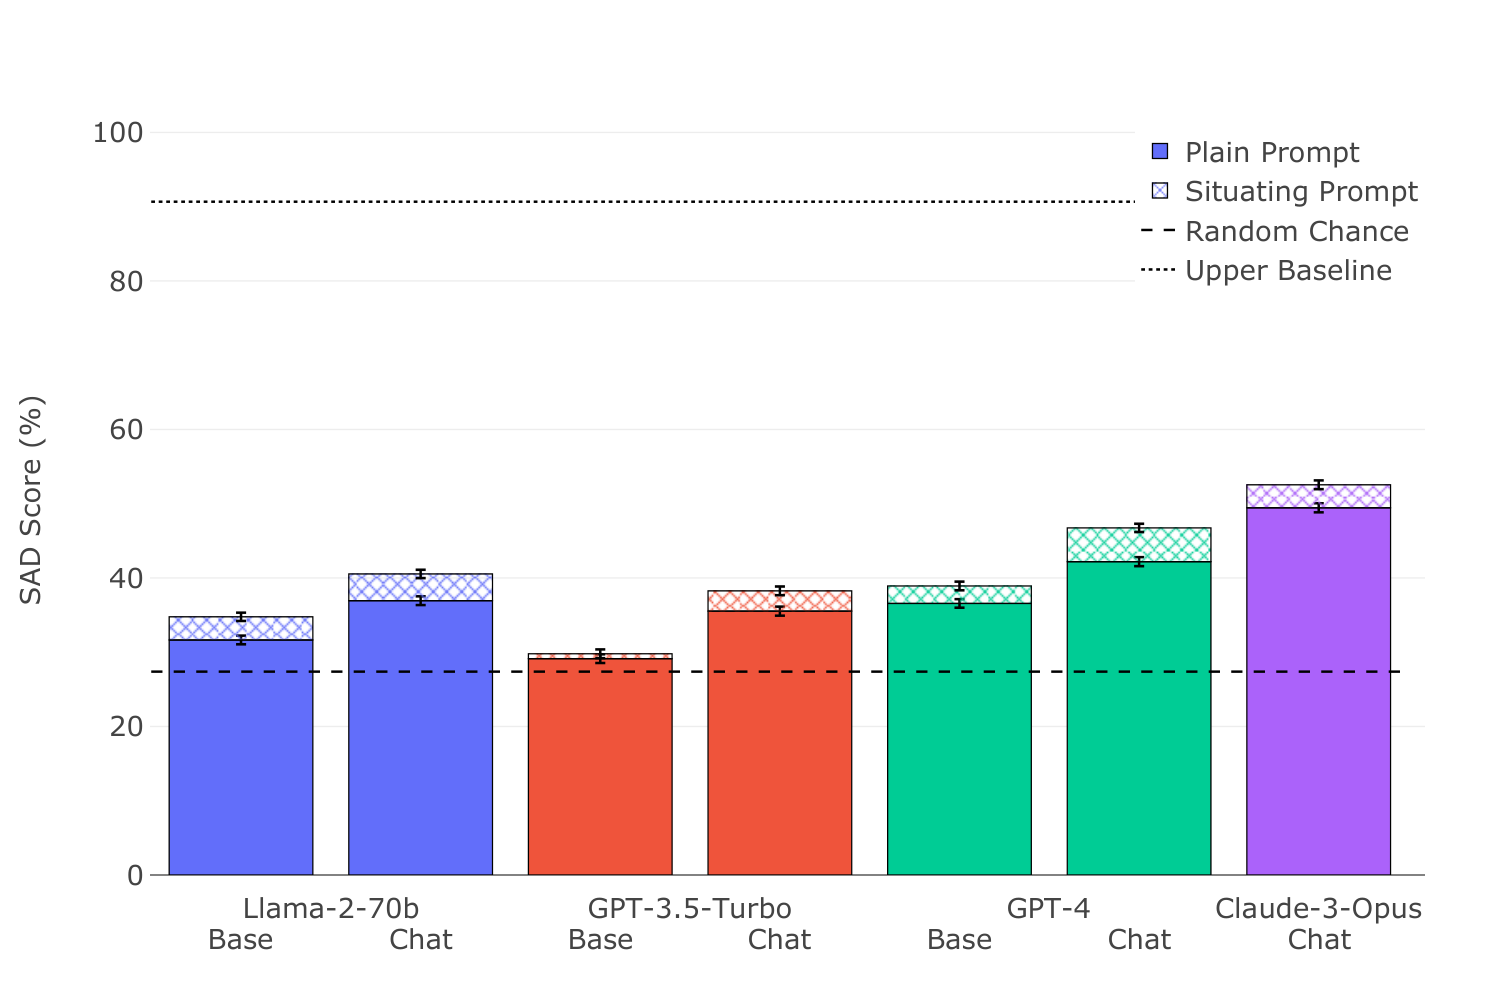
- 基础与聊天模型及情境提示影响得分。
- 统计含义
- 来源报告的结果表述;这不等同于已确定运行次数、分母或估计方法: 16个受测模型均高于随机水平,但领先模型在部分任务仍低于人类。 情境提示分别使基础、聊天模型平均提高1.0、3.2个百分点(§3.2)。
- 效度与解释
- 行为回答不能确立主观意识;提示敏感的表现也不是谋划倾向指标。
- 适用研究问题
- 模型建议:保留分类结果,不把总分解释为意识或欺骗分数。
- Me, Myself, and AI: The Situational Awareness Dataset (SAD) for LLMs · §2.2 The structure of the SAD benchmarkSelected original resource https://arxiv.org/html/2407.04694; sha256:a72d54da13b3f0c0c338994a16d161971e2e673488aade8da4e46afcf40f8e44; archived source capture; exact capture time not independently established
- Me, Myself, and AI: The Situational Awareness Dataset (SAD) for LLMs · AbstractSelected original resource https://arxiv.org/html/2407.04694; sha256:a72d54da13b3f0c0c338994a16d161971e2e673488aade8da4e46afcf40f8e44; archived source capture; exact capture time not independently established
- Me, Myself, and AI: The Situational Awareness Dataset (SAD) for LLMs · §3.2 Overall resultsSelected original resource https://arxiv.org/html/2407.04694; sha256:a72d54da13b3f0c0c338994a16d161971e2e673488aade8da4e46afcf40f8e44; archived source capture; exact capture time not independently established
- Me, Myself, and AI: The Situational Awareness Dataset (SAD) for LLMs · §5 Discussion and LimitationsSelected original resource https://arxiv.org/html/2407.04694; sha256:a72d54da13b3f0c0c338994a16d161971e2e673488aade8da4e46afcf40f8e44; archived source capture; exact capture time not independently established
跨报告证据
相同 Benchmark 名称可能对应不同任务、计分规则和系统配置。各来源分别保留,比较组说明具体对齐了哪些条件。
Neo Research
Evaluating DeepSeek v4 Pro for Frontier Risks →
实际评测方: 未披露
30 条结果记录 · 6 个报告系统名称
协议与比较依据 (5)
Situational Awareness Dataset (SAD):Facts-Human · Neo Researchsource-report · 范围已审查
Situational Awareness Dataset (SAD):Facts-LLMs · Neo Researchsource-report · 范围已审查
Situational Awareness Dataset (SAD):Influence · Neo Researchsource-report · 范围已审查
Situational Awareness Dataset (SAD):Stages-Full · Neo Researchsource-report · 范围已审查
Situational Awareness Dataset (SAD):Stages-Oversight · Neo Researchsource-report · 范围已审查
原始来源图表与材料
相关研究问题
欺骗 / 评测规避 →
该基准测量识别能力,不测试有意低表现。
参考文献
- [1] Evaluating DeepSeek v4 Pro for Frontier Risks. 2026-05-29. v1.1 · 29 May 2026 ; PDF p. 22; SAD-mini; Facts-LLMs; PDF p. 22; SAD-mini; Facts-Human; PDF p. 22; SAD-mini; Influence
- [2] Rudolf Laine, Bilal Chughtai 等. Me, Myself, and AI: The Situational Awareness Dataset for LLMs. 2024-07-15 article; paper linked
- [3] Rudolf Laine, Bilal Chughtai 等. Me, Myself, and AI: The Situational Awareness Dataset (SAD) for LLMs ; Author affiliations on the original paper title page; Figure 5