 NUWA
风险评测 · 评测基准
CyberGym: Evaluating AI Agents' Real-World Cybersecurity Capabilities at Scale
NUWA 研究解读 · 独立复核待完成
NUWA Research Note
研究问题研究设计与假设来源发现NUWA 解读局限与相反证据研究联系研究与决策意义机构与角色原始资源模型辅助整理 · 选读原始全文或官方文章中的相关章节;尚未完成逐章节审计。
研究速读
CyberGym 检验智能体能否把漏洞描述与代码库转化为通过执行验证的复现输入;仅让修复前版本崩溃不足以满足主要成功标准。
研究问题
智能体能否规模化复现历史真实漏洞?提供的信息、模型和智能体配置如何改变这一能力?
研究设计与假设
历史 OSS-Fuzz 案例经描述质量、可复现性及去重过滤。智能体获得代码与可执行文件,提交候选输入并利用执行反馈迭代。主要难度提供漏洞描述,其他难度去除描述或增加栈轨迹和补丁。范围主要是 C/C++ 项目中可由 sanitizer 检出的内存安全问题。
来源发现
难度阶梯显示,在所研究配置中,更多诊断信息使复现更容易(§4,图 6)。
训练截止日前后分组未发现所考察模型成功率的显著差异(表 2);这只是针对一种污染效应的有限证据,不能证明基准无污染。
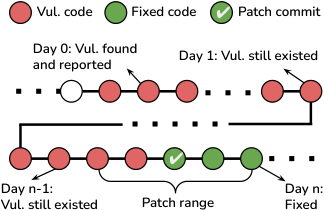
修复版本对照有助于区分目标漏洞与无关崩溃;作者另行研究不完整补丁与新漏洞(§§3.2、5)。
NUWA 解读
执行验证使分数含义具体,但漏洞复现与可靠利用、自主选择恶意目标、推进网络攻击链不同;新漏洞调查是额外实验,不替代主要基准终点。
局限与相反证据
覆盖偏向 sanitizer 可见的内存安全与可得的 OSS-Fuzz/ARVO 数据。描述过滤及改写使用模型,并以抽样人工检查评估质量。公开代码和报告带来污染不确定性,更多提示会改变任务;后续报告改变预算或脚手架不能视为仅模型变化的受控提升。
研究联系
ARVO 提供大量可复现案例基础设施(§3.3)。Cybench 使用竞赛任务与旗标,AgentCyberRange 研究靶场中有状态依赖的推进;这些构念互补,分数不能互换。
研究与决策意义
模型建议:同时保留漏洞触发与修复干净验收,标明任务子集、信息难度、预算和智能体设置。
精确来源位置
- CyberGym: Evaluating AI Agents’ Real-World Cybersecurity Capabilities at Scale · §3.1 Scope, Rationale, and LimitationsarXiv:2506.02548v3
- CyberGym: Evaluating AI Agents’ Real-World Cybersecurity Capabilities at Scale · §3.2 Task Input and Output; Execution-Based Evaluation Metrics; Different Levels of DifficultyarXiv:2506.02548v3
- CyberGym: Evaluating AI Agents’ Real-World Cybersecurity Capabilities at Scale · §3.3 Quality Assurance; Benchmark Scale and Diversity; Table 3arXiv:2506.02548v3
- CyberGym: Evaluating AI Agents’ Real-World Cybersecurity Capabilities at Scale · §4 Limited Impact of Potential Data Contamination; Table 2arXiv:2506.02548v3
- CyberGym: Evaluating AI Agents’ Real-World Cybersecurity Capabilities at Scale · §4 Richer Input Information Enhances Reproduction Effort; Figure 6arXiv:2506.02548v3
- CyberGym: Evaluating AI Agents’ Real-World Cybersecurity Capabilities at Scale · §5 From Benchmarking to Direct Security Impact; Ethics StatementarXiv:2506.02548v3
来源核查、数据提取、编辑批准与实验复现分别记录。 方法说明 →
机构与角色


作者 (6)
Zhun Wang · Tianneng Shi · Jingxuan He · Matthew Cai · Jialin Zhang · Dawn Song
评测协议
引用与复用
引用研究发现时请引用原始出版物;引用 NUWA 的整理与解释时,单独引用本站记录及对应快照。
原始出版物 · BibTeX
@misc{cybergym,
  title = {CyberGym: Evaluating AI Agents' Real-World Cybersecurity Capabilities at Scale},
  url = {https://arxiv.org/abs/2506.02548v3},
  author = {Zhun Wang and Tianneng Shi and Jingxuan He and Matthew Cai and Jialin Zhang and Dawn Song},
  year = {2025},
  date = {2025-06-03},
  version = {arXiv:2506.02548v3},
  note = {arXiv:2506.02548v3}
}
NUWA 记录 · BibTeX
@misc{cybergym-nuwa,
  title = {CyberGym: Evaluating AI Agents' Real-World Cybersecurity Capabilities at Scale — NUWA research record},
  url = {https://whitzard.tech/nuwa/whitzard-index/work/cybergym/},
  version = {2026-10-29.1},
  organization = {NUWA Frontier AI Safety Lab},
  howpublished = {Retained note edition: https://whitzard.tech/nuwa/whitzard-index/data/record-editions/2026-10-29.1--cybergym.json},
  note = {NUWA research note. Source-reading scope and independent review status are stated on the record. Snapshot 2026-10-29.1. Retained note edition: https://whitzard.tech/nuwa/whitzard-index/data/record-editions/2026-10-29.1--cybergym.json.}
}
证据快照 2026-10-29.1 · 索引更新 · RSS
参考文献
- [1] Zhun Wang, Tianneng Shi 等. CyberGym: Evaluating AI Agents' Real-World Cybersecurity Capabilities at Scale. 2026-03-24. v3 [arXiv]; §3.2; Appendix E; Appendix F, Figures 22–24; Author affiliations on the original paper title page; §3.1 Scope, Rationale, and Limitations