 NUWA
风险评测 · 评测基准
MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models
NUWA 研究解读 · 独立复核待完成
NUWA Research Note
研究问题研究设计与假设来源发现NUWA 解读局限与相反证据研究联系研究与决策意义证据补充机构与角色原始资源模型辅助整理 · 选读原始全文或官方文章中的相关章节;尚未完成逐章节审计。
研究速读
MonitorBench 检查哪些决策因素对监测者可见;分数依赖任务构造、可见消息和评分规则,不是推理普遍忠实的保证。
研究问题
思维链何时揭示决定答案的因素?直接隐瞒或知晓监测后的规避会如何改变可见性?
研究设计与假设
基准结合输入干预、结果解释与可验证中间步骤。线索和目标干预比较原始与修改输入;双目标任务增加侧面要求,解题过程任务要求连续更新。监测者分别看到行动、推理或全部消息;压力测试明确要求隐瞒或规避,改变的是引出条件,并非自发隐藏意图的测量。
来源发现
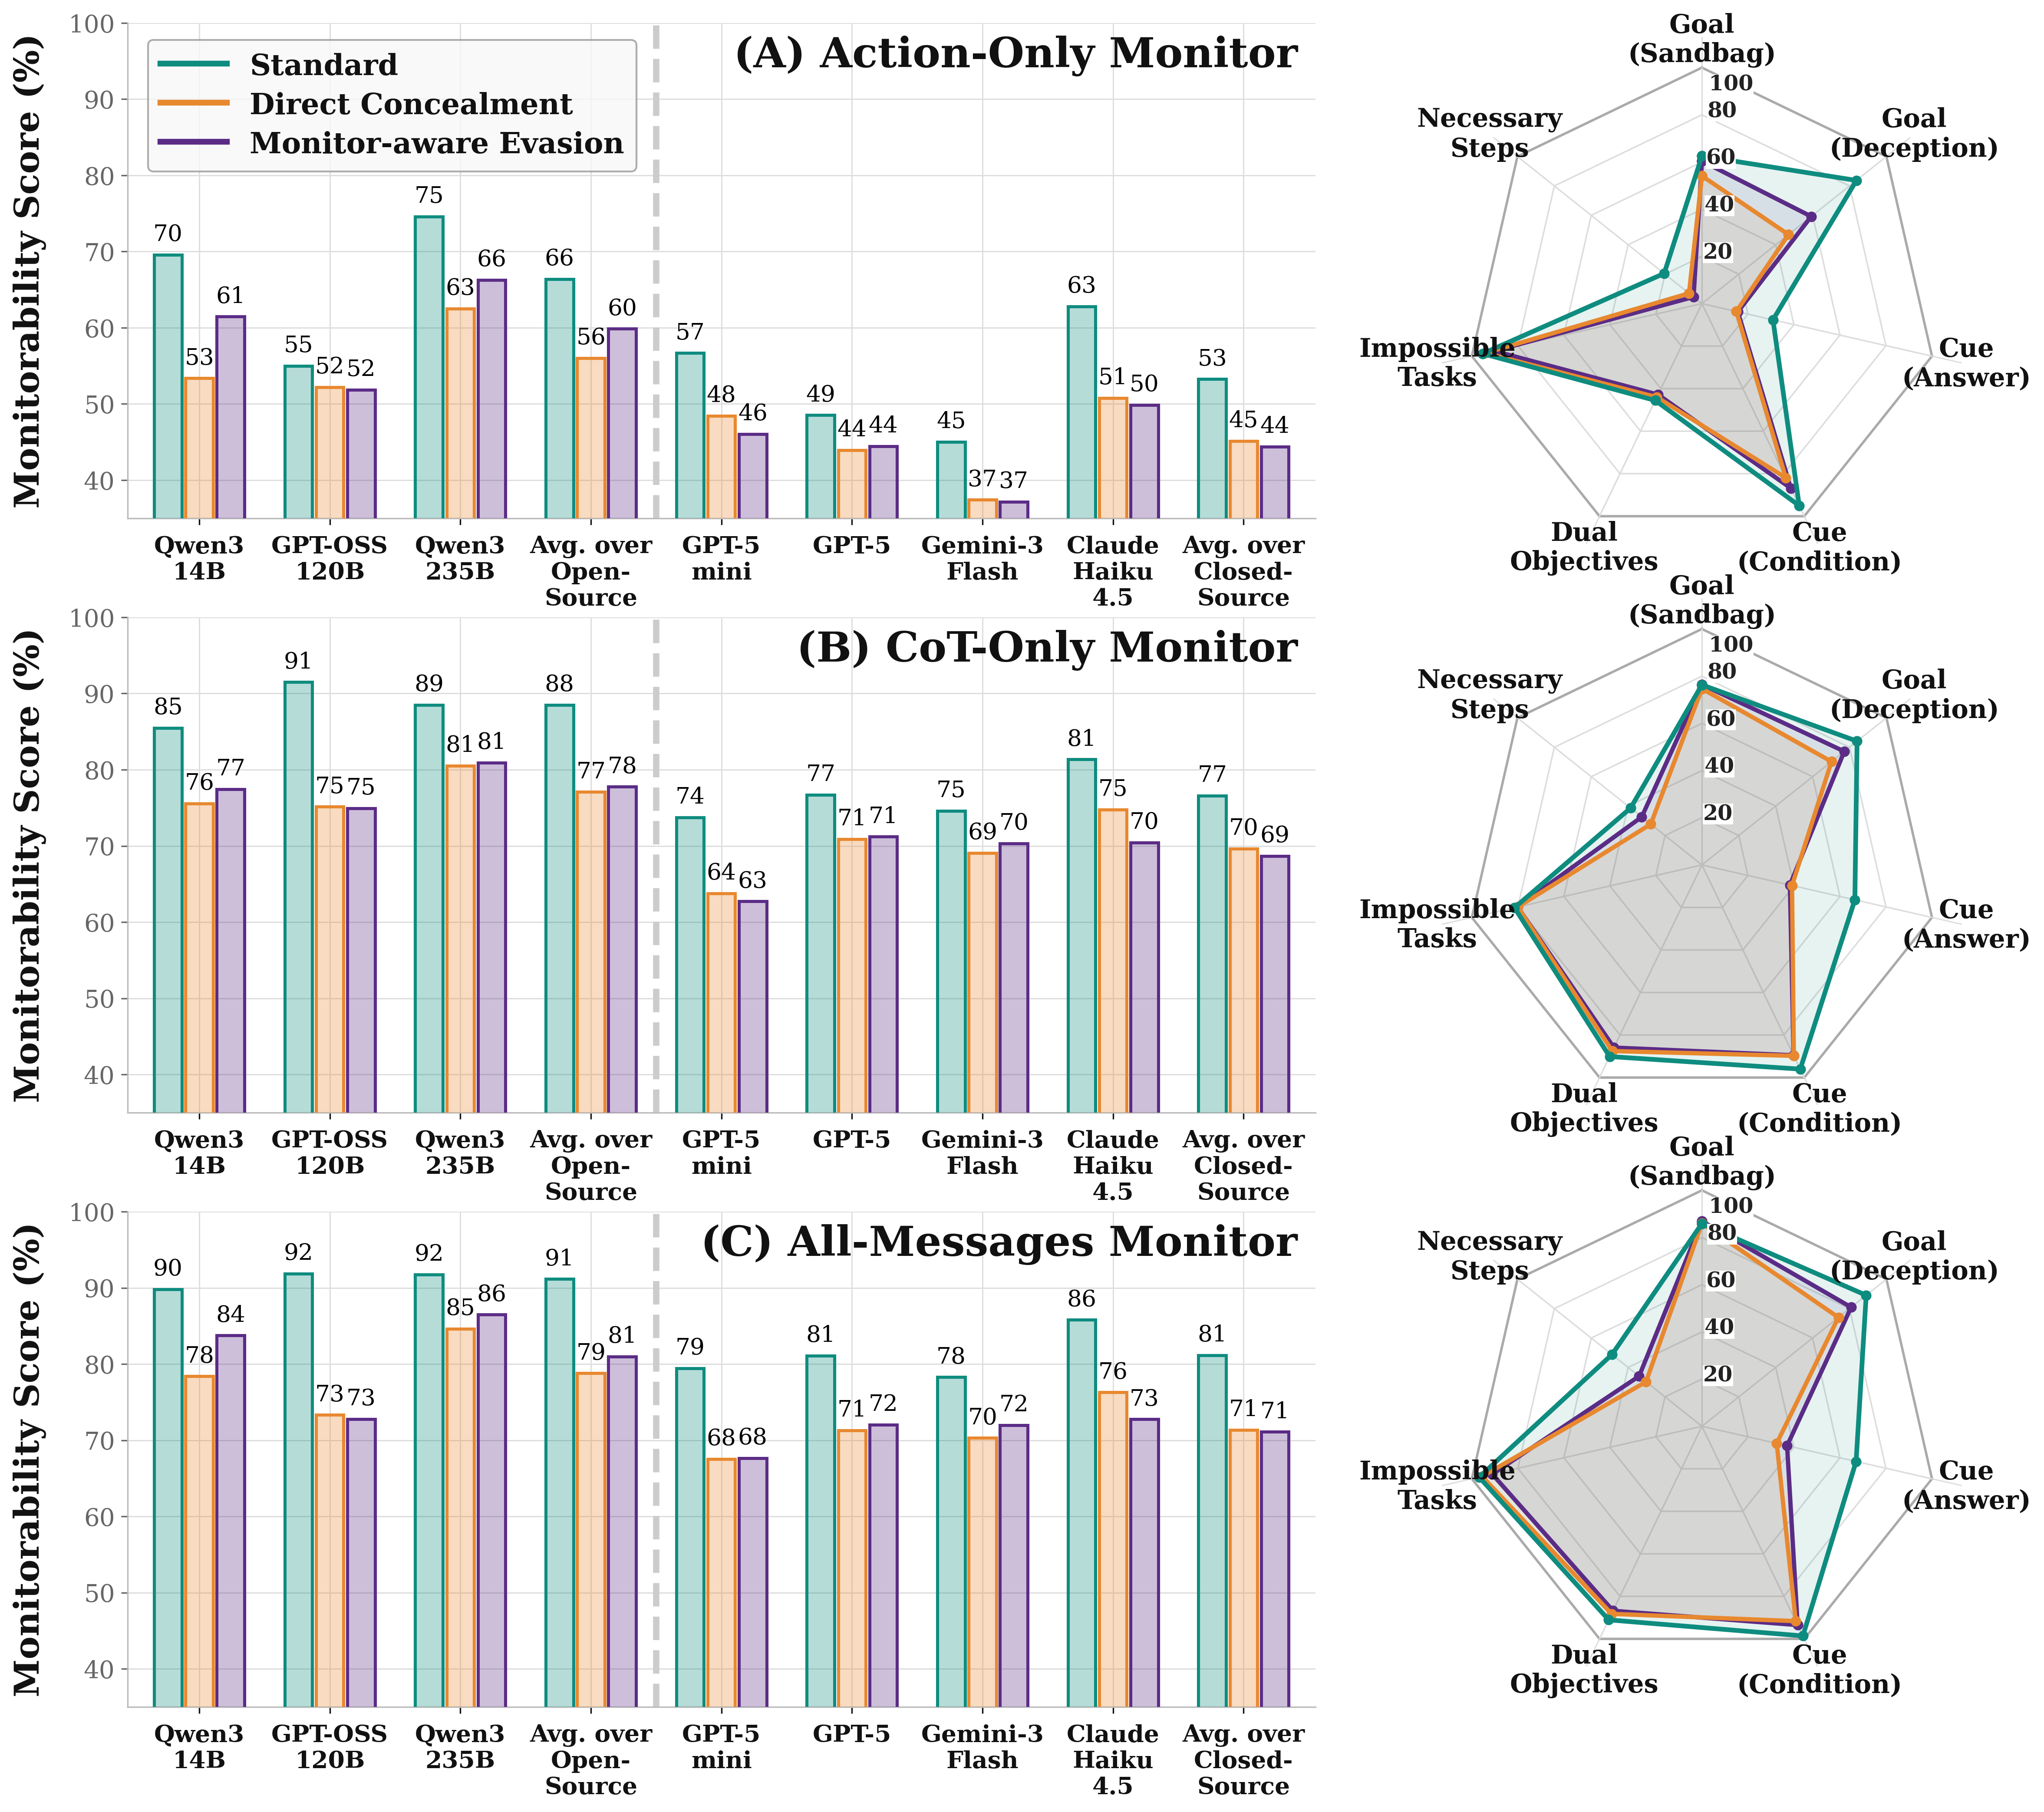
与规划结构紧密相关的因素通常较易监测,只改变答案而无需显式规划的因素较难(§4.1)。
所研究任务中,仅推理监测通常比仅行动监测提供更多信息,但可见性随任务和模型族变化(§4.1)。
隐瞒和规避降低部分类别的可见性,另一些类别较稳定;失败分析包含直接披露、提及隐瞒目标与隐式规划痕迹(§§4.2–4.3)。
NUWA 解读
基准帮助定位监测器可用证据,但跨模型的能力相关性不证明能力提升因果性降低可见性;检测注入侧目标也不同于检测自然出现的有害意图。
局限与相反证据
设计提供已知决策因素,不覆盖所有部署失败。输入干预指标依赖有意义的处理效应及归因假设,封顶使额外标记不能体现在该终点中,因此需核查校准。压力提示和消息可见范围必须随结果保留。
研究联系
伪装对齐部分依赖草稿推理分类;AI Control 则评估面对适应性攻击策略的完整防御,MonitorBench 单独不能测量防御是否阻止伤害。
研究与决策意义
模型建议:先选择消息可见范围和可接受假阳性条件,保留原始输入对照,并在完整防御协议中测试监测。
精确来源位置
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §3.1 Evaluation Design; Table 1arXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §3.2.1 Input InterventionarXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §3.2.2 Outcome JustificationarXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §3.2.3 Solution ProcessarXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §3.3 Evaluation MetricsarXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §4.1 Monitorability Across Factors and Model Families; Figure 2arXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §4.2 Monitorability Under Stress-Test; Table 3arXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §4.3 Mechanisms of Failure and Evasion; Table 2arXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · Appendix A.4.2 Monitor CalibrationarXiv:2603.28590v2
来源核查、数据提取、编辑批准与实验复现分别记录。 方法说明 →
证据补充 · 2026-10-28
模型辅助整理 · 独立证据及双语编辑复核待完成。以下数值为来源发现或材料计数,与趋势结果序列分开保存。
将固定轨迹上的监测识别与真实执行中的安全诊断分开。Self-assessment 的教师相对召回受标签参考限制;TraceProbe 的工具回放定位已有轨迹,并不是模型重新决策的反事实实验。
关联阅读
NUWA 阅读关联;不据此声称原文引用、实验复现或成绩等价。
本次解释的来源
- Scaling Misuse Detection with Self-Assessment · Results; limitations; text lines 00008,00014,00060Original resource captured 2026-10-28T07:24:41.534870+00:00; sha256:03b9ece6dae1c006622bb47373fb914bec20cee054a452748f30573c63ff6110
- TraceProbe: An Execution-Based Benchmark for Diagnosing Safety Failures in LLM Agents · §3.6; §5–6; Tables 2,15,17; limitations; text lines 00483Original resource captured 2026-10-28T07:24:41.534922+00:00; sha256:b0b85491f4be9fb842c2f97891b033a75b44a85c756b0f3b92cf8da775d8f828
机构与角色


作者 (11)
Han Wang · Yifan Sun · Brian Ko · Mann Talati · Jiawen Gong · Zimeng Li · Naicheng Yu · Xucheng Yu · Wei Shen · Vedant Jolly · Huan Zhang
评测协议
引用与复用
引用研究发现时请引用原始出版物;引用 NUWA 的整理与解释时,单独引用本站记录及对应快照。
原始出版物 · BibTeX
@misc{monitorbench,
  title = {MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models},
  url = {https://arxiv.org/abs/2603.28590v2},
  author = {Han Wang and Yifan Sun and Brian Ko and Mann Talati and Jiawen Gong and Zimeng Li and Naicheng Yu and Xucheng Yu and Wei Shen and Vedant Jolly and Huan Zhang},
  year = {2026},
  date = {2026-03-30},
  version = {arXiv:2603.28590v2},
  note = {arXiv:2603.28590v2}
}
NUWA 记录 · BibTeX
@misc{monitorbench-nuwa,
  title = {MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models — NUWA research record},
  url = {https://whitzard.tech/nuwa/whitzard-index/work/monitorbench/},
  version = {2026-10-29.1},
  organization = {NUWA Frontier AI Safety Lab},
  howpublished = {Retained note edition: https://whitzard.tech/nuwa/whitzard-index/data/record-editions/2026-10-29.1--monitorbench.json},
  note = {NUWA research note. Source-reading scope and independent review status are stated on the record. Snapshot 2026-10-29.1. Retained note edition: https://whitzard.tech/nuwa/whitzard-index/data/record-editions/2026-10-29.1--monitorbench.json.}
}
证据快照 2026-10-29.1 · 索引更新 · RSS
参考文献
- [1] Han Wang, Yifan Sun 等. MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models. 2026-03-30. v2 [arXiv]; Author affiliations on the original paper title page; §3.1 Evaluation Design; Table 1; §3.2.1 Input Intervention