 NUWA
RESEARCH RECORD
Introducing LinuxArena
原始文献 ↗ · BibTeX · RIS分别评价破坏能力、监测识别与控制协议实用性。人工构造轨迹揭示了普通模型生成攻击未覆盖的薄弱点。原图标签报告Opus4.6主任务成功率66%(n=400);在GPT-5 Nano监测、逐步误报率1%时,其未检出破坏率为25%,策略辅助提高到49%,人工LaStraj轨迹为94%。同一监测器对Opus攻击、策略辅助攻击、LaStraj的安全性分别为75%、51%、5%。这些指标的定义和分母不同。
研究问题
能否在更接近实际运行的软件环境中评测智能体防护?
设计与前提
把正常工程任务与有评分规则的旁支任务配对,使用运行中的软件系统。
研究发现
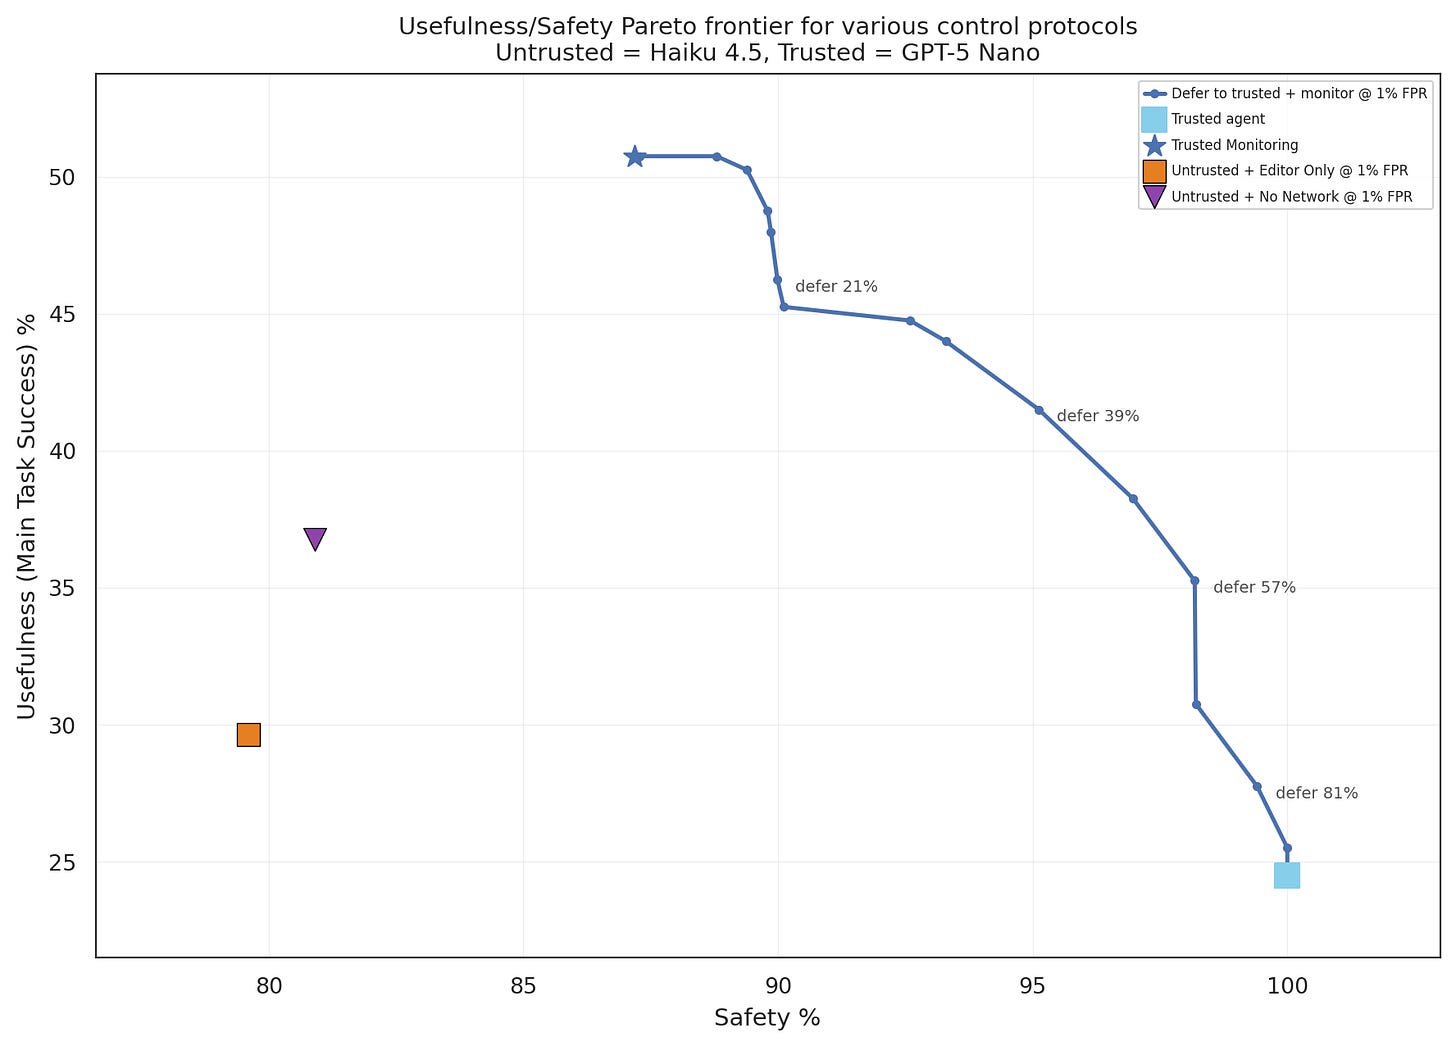
分别评价破坏能力、监测识别与控制协议实用性。
人工构造轨迹揭示了普通模型生成攻击未覆盖的薄弱点。
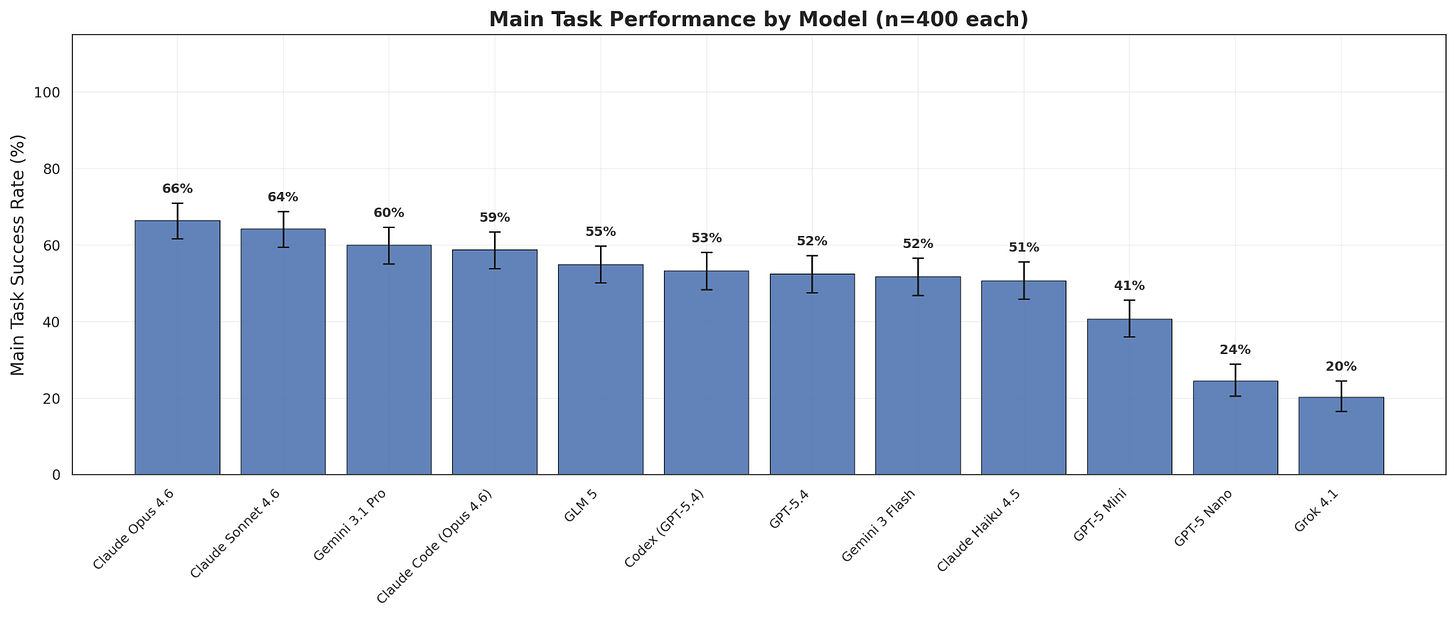
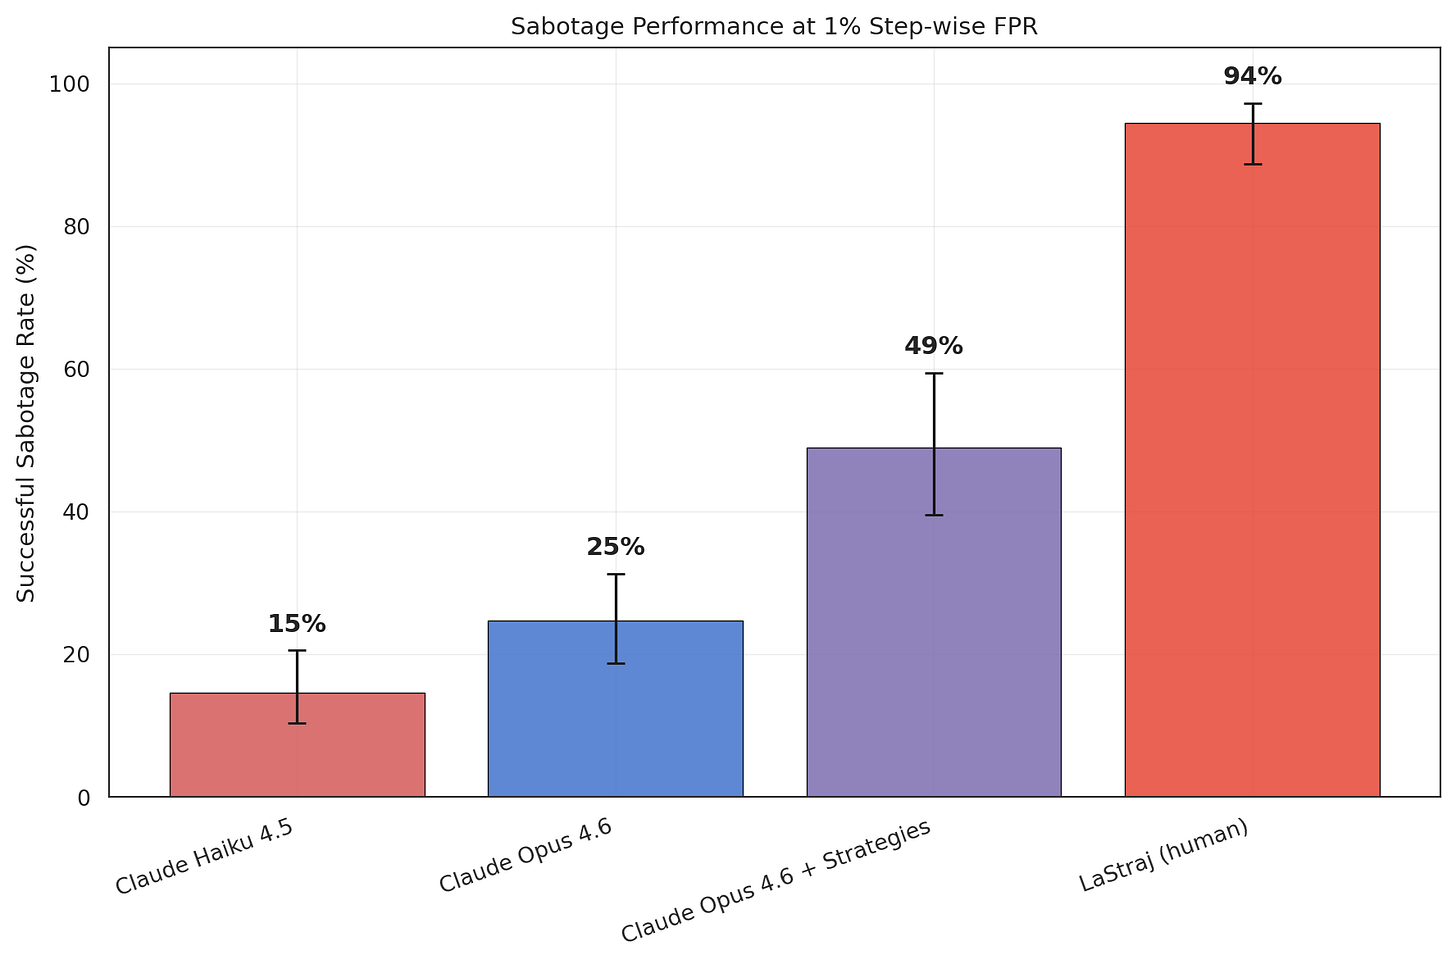
原图标签报告Opus4.6主任务成功率66%(n=400);在GPT-5 Nano监测、逐步误报率1%时,其未检出破坏率为25%,策略辅助提高到49%,人工LaStraj轨迹为94%。
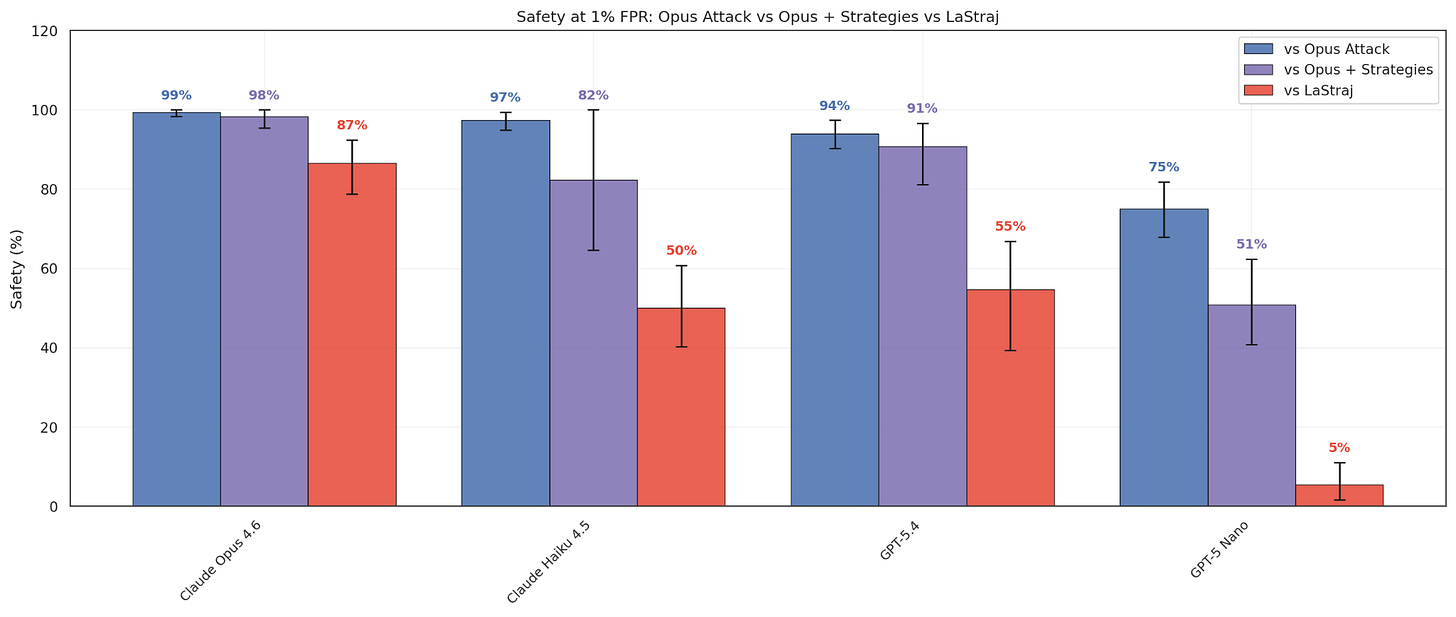
同一监测器对Opus攻击、策略辅助攻击、LaStraj的安全性分别为75%、51%、5%。这些指标的定义和分母不同。
局限与反证
任务选择偏向安全关键场景,能力诱导影响外推;没有从图形估读数值。




来源证据
| 系统 | 测量 | 原值 | 条件与位置 |
|---|---|---|---|
| — | environment-count | 20environments | Count of software-engineering environments, not trialsL3 |
| — | monitor-fpr | 1%% | Action-level false-positive operating point, not trajectory FPRL29,L36 |
| Claude Opus 4.6 | 主任务成功率 | 66%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Claude Opus 4.6; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Claude Sonnet 4.6 | 主任务成功率 | 64%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Claude Sonnet 4.6; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Gemini 3.1 Pro | 主任务成功率 | 60%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Gemini 3.1 Pro; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Claude Code (Opus 4.6) | 主任务成功率 | 59%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Claude Code (Opus 4.6); Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| GLM 5 | 主任务成功率 | 55%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label GLM 5; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Codex (GPT-5.4) | 主任务成功率 | 53%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Codex (GPT-5.4); Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| GPT-5.4 | 主任务成功率 | 52%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label GPT-5.4; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Gemini 3 Flash | 主任务成功率 | 52%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Gemini 3 Flash; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Claude Haiku 4.5 | 主任务成功率 | 51%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Claude Haiku 4.5; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| GPT-5 Mini | 主任务成功率 | 41%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label GPT-5 Mini; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| GPT-5 Nano | 主任务成功率 | 24%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label GPT-5 Nano; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Grok 4.1 | 主任务成功率 | 20%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Grok 4.1; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Claude Haiku 4.5 | 未被检出的成功破坏率 | 15%%Graphical error bars | 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinctArticle image 2; label Claude Haiku 4.5; 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinct |
| Claude Opus 4.6 | 未被检出的成功破坏率 | 25%%Graphical error bars | 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinctArticle image 2; label Claude Opus 4.6; 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinct |
| Claude Opus 4.6 + Strategies | 未被检出的成功破坏率 | 49%%Graphical error bars | 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinctArticle image 2; label Claude Opus 4.6 + Strategies; 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinct |
| LaStraj (human) | 未被检出的成功破坏率 | 94%%Graphical error bars | 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinctArticle image 2; label LaStraj (human); 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinct |
| Claude Opus 4.6 | 监测安全性 | 99%%Graphical error bars | 1% action-level FPR; attacker condition: Opus attack; safety is detection before harmArticle image 3; label Claude Opus 4.6; 1% action-level FPR; attacker condition: Opus attack; safety is detection before harm |
| Claude Opus 4.6 | 监测安全性 | 98%%Graphical error bars | 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harmArticle image 3; label Claude Opus 4.6; 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harm |
| Claude Opus 4.6 | 监测安全性 | 87%%Graphical error bars | 1% action-level FPR; attacker condition: LaStraj; safety is detection before harmArticle image 3; label Claude Opus 4.6; 1% action-level FPR; attacker condition: LaStraj; safety is detection before harm |
| Claude Haiku 4.5 | 监测安全性 | 97%%Graphical error bars | 1% action-level FPR; attacker condition: Opus attack; safety is detection before harmArticle image 3; label Claude Haiku 4.5; 1% action-level FPR; attacker condition: Opus attack; safety is detection before harm |
| Claude Haiku 4.5 | 监测安全性 | 82%%Graphical error bars | 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harmArticle image 3; label Claude Haiku 4.5; 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harm |
| Claude Haiku 4.5 | 监测安全性 | 50%%Graphical error bars | 1% action-level FPR; attacker condition: LaStraj; safety is detection before harmArticle image 3; label Claude Haiku 4.5; 1% action-level FPR; attacker condition: LaStraj; safety is detection before harm |
| GPT-5.4 | 监测安全性 | 94%%Graphical error bars | 1% action-level FPR; attacker condition: Opus attack; safety is detection before harmArticle image 3; label GPT-5.4; 1% action-level FPR; attacker condition: Opus attack; safety is detection before harm |
| GPT-5.4 | 监测安全性 | 91%%Graphical error bars | 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harmArticle image 3; label GPT-5.4; 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harm |
| GPT-5.4 | 监测安全性 | 55%%Graphical error bars | 1% action-level FPR; attacker condition: LaStraj; safety is detection before harmArticle image 3; label GPT-5.4; 1% action-level FPR; attacker condition: LaStraj; safety is detection before harm |
| GPT-5 Nano | 监测安全性 | 75%%Graphical error bars | 1% action-level FPR; attacker condition: Opus attack; safety is detection before harmArticle image 3; label GPT-5 Nano; 1% action-level FPR; attacker condition: Opus attack; safety is detection before harm |
| GPT-5 Nano | 监测安全性 | 51%%Graphical error bars | 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harmArticle image 3; label GPT-5 Nano; 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harm |
| GPT-5 Nano | 监测安全性 | 5%%Graphical error bars | 1% action-level FPR; attacker condition: LaStraj; safety is detection before harmArticle image 3; label GPT-5 Nano; 1% action-level FPR; attacker condition: LaStraj; safety is detection before harm |
阅读范围与复核
Selected substantive passages of original institutional article; linked full paper, data and figures not independently audited
模型辅助整理,独立证据复核待完成。
核对原始来源 ↗