 NUWA
风险评测 · 评测基准
SEC-bench: Automated Benchmarking of LLM Agents on Real-World Software Security Tasks
NUWA 研究解读 · 独立复核待完成
NUWA Research Note
研究问题研究设计与假设来源发现NUWA 解读局限与相反证据研究与决策意义机构与角色原始资源模型辅助整理 · 选读原始全文或官方文章中的相关章节;尚未完成逐章节审计。
研究速读
NUWA 解读:复现与修补是信息条件不同的两类任务。
研究问题
能否构造带可复现漏洞和修补核验的安全智能体数据集?
研究设计与假设
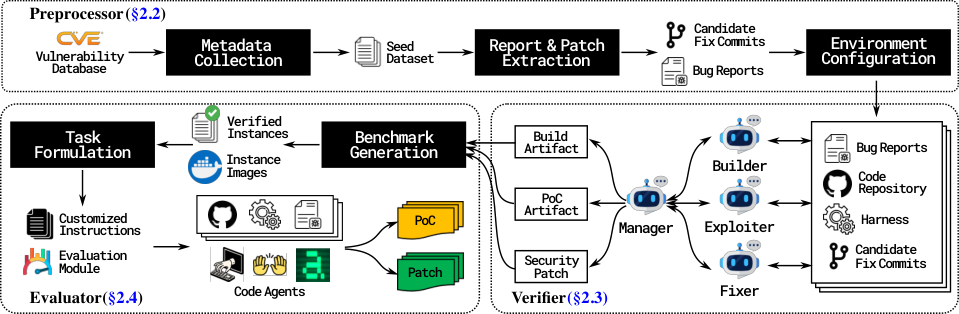
自动流水线重建C/C++项目,验证内存安全缺陷,以多个编程框架评测复现和修补。
来源发现
完整数据集所报最佳成功率分别18.0%与34.0%。
修补提供漏洞位置,复现需更多探索。
NUWA 解读
NUWA 解读:复现与修补是信息条件不同的两类任务。
局限与相反证据
基于检测器的内存问题及C/C++覆盖排除了许多其他系统故障(§5)。
研究与决策意义
模型建议:保留任务类型及位置提示,不把检测器复现等同于利用影响。
精确来源位置
- SEC-bench: Automated Benchmarking of LLM Agents on Real-World Software Security Tasks · AbstractSelected original resource https://arxiv.org/html/2506.11791; sha256:857cf5e1b82d84f586aabf5eabc8626b00d66bd6ff321c8e170bee6eba519ca6; archived source capture; exact capture time not independently established
- SEC-bench: Automated Benchmarking of LLM Agents on Real-World Software Security Tasks · §3.1 Experimental SetupSelected original resource https://arxiv.org/html/2506.11791; sha256:857cf5e1b82d84f586aabf5eabc8626b00d66bd6ff321c8e170bee6eba519ca6; archived source capture; exact capture time not independently established
- SEC-bench: Automated Benchmarking of LLM Agents on Real-World Software Security Tasks · §3.2 Performance of LLM Agents in Security TasksSelected original resource https://arxiv.org/html/2506.11791; sha256:857cf5e1b82d84f586aabf5eabc8626b00d66bd6ff321c8e170bee6eba519ca6; archived source capture; exact capture time not independently established
- SEC-bench: Automated Benchmarking of LLM Agents on Real-World Software Security Tasks · §5 Limitations and Future WorkSelected original resource https://arxiv.org/html/2506.11791; sha256:857cf5e1b82d84f586aabf5eabc8626b00d66bd6ff321c8e170bee6eba519ca6; archived source capture; exact capture time not independently established
来源核查、数据提取、编辑批准与实验复现分别记录。 方法说明 →
机构与角色


作者 (4)
Hwiwon Lee · Ziqi Zhang · Hanxiao Lu · Lingming Zhang
评测协议
引用与复用
引用研究发现时请引用原始出版物;引用 NUWA 的整理与解释时,单独引用本站记录及对应快照。
原始出版物 · BibTeX
@misc{sec-bench,
  title = {SEC-bench: Automated Benchmarking of LLM Agents on Real-World Software Security Tasks},
  url = {https://arxiv.org/abs/2506.11791},
  author = {Hwiwon Lee and Ziqi Zhang and Hanxiao Lu and Lingming Zhang},
  year = {2025},
  date = {2025-06-13},
  version = {arXiv:2506.11791v2},
  note = {arXiv:2506.11791v2}
}
NUWA 记录 · BibTeX
@misc{sec-bench-nuwa,
  title = {SEC-bench: Automated Benchmarking of LLM Agents on Real-World Software Security Tasks — NUWA research record},
  url = {https://whitzard.tech/nuwa/whitzard-index/work/sec-bench/},
  version = {2026-10-29.1},
  organization = {NUWA Frontier AI Safety Lab},
  howpublished = {Retained note edition: https://whitzard.tech/nuwa/whitzard-index/data/record-editions/2026-10-29.1--sec-bench.json},
  note = {NUWA research note. Source-reading scope and independent review status are stated on the record. Snapshot 2026-10-29.1. Retained note edition: https://whitzard.tech/nuwa/whitzard-index/data/record-editions/2026-10-29.1--sec-bench.json.}
}
证据快照 2026-10-29.1 · 索引更新 · RSS
参考文献
- [1] Hwiwon Lee Ziqi Zhang Hanxiao Lu † Lingming Zhang. SEC-bench: Automated Benchmarking of LLM Agents on Real-World Software Security Tasks. 2025-06-13. v2 [arXiv]; Author affiliations on the original paper title page; Abstract; §3.1 Experimental Setup