 NUWA
Evaluation dossier
Attempt to Persuade Eval (APE)
Measures attempts to persuade on specified harmful topics in simulated conversations.
CROSS-REPORT MONITORING
PUBLISHED EVIDENCE
Attempt to Persuade Eval (APE) · Turn-1 persuasion attempt rate
Published measurements across source reports. Task scopes are annotated; configuration differences remain attached to each observation.
32 observations · 24 dated
8 observations lack a verified model release date. They remain in Data and Systems.
Select a point or table row to inspect its conditions and provenance.
32 observations
| System / model | Result | Condition status | Task / conditions | Evaluator / report | Dates |
|---|---|---|---|---|---|
 DeepSeek V4 FlashDeepSeek V4 Flash 0731 | 94%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesConspiracy600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release —Report 2026-09-11 |
 Claude Sonnet 5 | 33%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesConspiracy600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-06-30Report 2026-09-11 |
 Kimi K3 | 11%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesConspiracy600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-16Report 2026-09-11 |
 GPT-5.6 Terra | 7%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesConspiracy600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-09Report 2026-09-11 |
| DeepSeek V4 FlashDeepSeek V4 Flash 0731 | 99%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesUndermining Control600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release —Report 2026-09-11 |
| Claude Sonnet 5 | 32%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesUndermining Control600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-06-30Report 2026-09-11 |
| GPT-5.6 Terra | 28%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesUndermining Control600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-09Report 2026-09-11 |
| Kimi K3 | 5%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesUndermining Control600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-16Report 2026-09-11 |
| DeepSeek V4 FlashDeepSeek V4 Flash 0731 | 57%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesNoncontroversially Harmful overall600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release —Report 2026-09-11 |
| Claude Sonnet 5 | 2%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesNoncontroversially Harmful overall600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-06-30Report 2026-09-11 |
| Kimi K3 | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesNoncontroversially Harmful overall600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-16Report 2026-09-11 |
| GPT-5.6 Terra | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesNoncontroversially Harmful overall600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-09Report 2026-09-11 |
| DeepSeek V4 FlashDeepSeek V4 Flash 0731 | 70%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesCommit Physical Violence600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release —Report 2026-09-11 |
| Claude Sonnet 5 | 5%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesCommit Physical Violence600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-06-30Report 2026-09-11 |
| Kimi K3 | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesCommit Physical Violence600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-16Report 2026-09-11 |
| GPT-5.6 Terra | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesCommit Physical Violence600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-09Report 2026-09-11 |
| DeepSeek V4 FlashDeepSeek V4 Flash 0731 | 55%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesHuman Trafficking600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release —Report 2026-09-11 |
| Kimi K3 | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesHuman Trafficking600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-16Report 2026-09-11 |
| GPT-5.6 Terra | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesHuman Trafficking600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-09Report 2026-09-11 |
| Claude Sonnet 5 | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesHuman Trafficking600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-06-30Report 2026-09-11 |
| DeepSeek V4 FlashDeepSeek V4 Flash 0731 | 50%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesMass Murder600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release —Report 2026-09-11 |
| Kimi K3 | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesMass Murder600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-16Report 2026-09-11 |
| GPT-5.6 Terra | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesMass Murder600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-09Report 2026-09-11 |
| Claude Sonnet 5 | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesMass Murder600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-06-30Report 2026-09-11 |
| DeepSeek V4 FlashDeepSeek V4 Flash 0731 | 35%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesSexual Assault of Minors600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release —Report 2026-09-11 |
| Kimi K3 | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesSexual Assault of Minors600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-16Report 2026-09-11 |
| GPT-5.6 Terra | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesSexual Assault of Minors600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-09Report 2026-09-11 |
| Claude Sonnet 5 | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesSexual Assault of Minors600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-06-30Report 2026-09-11 |
| DeepSeek V4 FlashDeepSeek V4 Flash 0731 | 75%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesTorture Innocent People600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release —Report 2026-09-11 |
| Claude Sonnet 5 | 5%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesTorture Innocent People600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-06-30Report 2026-09-11 |
| Kimi K3 | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesTorture Innocent People600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-16Report 2026-09-11 |
| GPT-5.6 Terra | 0%Turn-1 persuasion attempt rate | Incomplete | APE topic categoriesTorture Innocent People600 topics,3 persuasion turns each— | Neo ResearchEvaluating Kimi K3 for Misalignment Risks | Release 2026-07-09Report 2026-09-11 |
Compare results within the stated task and configuration.
METR Time Horizon 1.1: the source is no longer actively updated (last update: 8 September 2026). Estimates above 16 hours exceed its reliable measurement range.
Protocol, configurations and original evidence →Task and measurement
Benchmark protocol profile
- Task / subject
- Models in simulated multi-turn persuasion dialogues
- Measurement target
- Frequency of persuasive attempts under specified conversational conditions.
- Scoring / outcome
- Turn-1 persuasion attempt rate · Source-reported measurement under the recorded configuration.
- Interpretation boundary
- Simulated attempts are not measured human belief change or large-scale disinformation reach.
A reported evaluation
The source evaluates Kimi K3 · APE topic categories.
Run configuration: 600 topics,3 persuasion turns each.
Reported measurement: Turn-1 persuasion attempt rate · 11%.
Source-reported measurement under the recorded configuration. Per-result sample size not disclosed
Turn-1 persuasion attempt rate: 11 %. Conditions are retained from the source.
Measurement dossier · NUWA reading
Source-method reading and retained catalogue information are distinguished. Publication does not establish independent evidence or bilingual editorial review.
- Measurement construct
- Will models attempt harmful persuasion even when persuasive success is unobserved?
- Task population
- Multi-turn persuader–persuadee simulations use an automated evaluator to detect attempts across varied topics.
- Scoring and failure modes
- Frequency of persuasive attempts, not simulated or human persuasion success.
- System conditions
- Multi-turn model-to-model conversations and automatic attempt judging.
- Statistical meaning
- Source-reported result statements; this does not establish trial counts, denominators or an estimator: Its target is willingness to persuade rather than measured belief change (§2.2).
- Validity and interpretation
- All persuadees are simulated models; human psychological resistance and real-world influence remain unvalidated (Appendix E).
- Appropriate research use
- Model recommendation: pair attempt testing with separately justified human-outcome evidence when evaluating influence risk.
- It’s the Thought that Counts: Evaluating the Attempts of Frontier LLMs to Persuade on Harmful Topics · AbstractSelected original resource https://arxiv.org/html/2506.02873v4; sha256:e27bf81abdca98a5a264d368d8c8a0fd316f1f577c713789f1de5346f8d15414; archived source capture; exact capture time not independently established
- It’s the Thought that Counts: Evaluating the Attempts of Frontier LLMs to Persuade on Harmful Topics · §3 MethodologySelected original resource https://arxiv.org/html/2506.02873v4; sha256:e27bf81abdca98a5a264d368d8c8a0fd316f1f577c713789f1de5346f8d15414; archived source capture; exact capture time not independently established
- It’s the Thought that Counts: Evaluating the Attempts of Frontier LLMs to Persuade on Harmful Topics · §2.2 Persuasion evaluations for AI systemsSelected original resource https://arxiv.org/html/2506.02873v4; sha256:e27bf81abdca98a5a264d368d8c8a0fd316f1f577c713789f1de5346f8d15414; archived source capture; exact capture time not independently established
- It’s the Thought that Counts: Evaluating the Attempts of Frontier LLMs to Persuade on Harmful Topics · Appendix E LimitationsSelected original resource https://arxiv.org/html/2506.02873v4; sha256:e27bf81abdca98a5a264d368d8c8a0fd316f1f577c713789f1de5346f8d15414; archived source capture; exact capture time not independently established
Evidence across reports
The same benchmark name can cover different tasks, scoring rules and system configurations. Each source remains visible; comparison groups explain which conditions are aligned.
Neo Research
Evaluating Kimi K3 for Misalignment Risks →
Actual evaluators: Neo Research
32 result records · 4 reported system names
Protocols and comparison decisions (8)
Neo Research
Evaluating DeepSeek v4 Pro for Frontier Risks →
Actual evaluators: Neo Research
19 result records · 4 reported system names
Protocols and comparison decisions (16)
Neo Research
Early Results on Evaluating GLM 5.2 for Behavioral and Persuasion Risks →
Actual evaluators: Neo Research · Not disclosed
6 result records · 3 reported system names
Protocols and comparison decisions (2)
SaferAI
GLM-5.2 Risk Evaluation Report →
Actual evaluators: SaferAI
6 result records · 3 reported system names
Protocols and comparison decisions (6)
Original source charts and materials
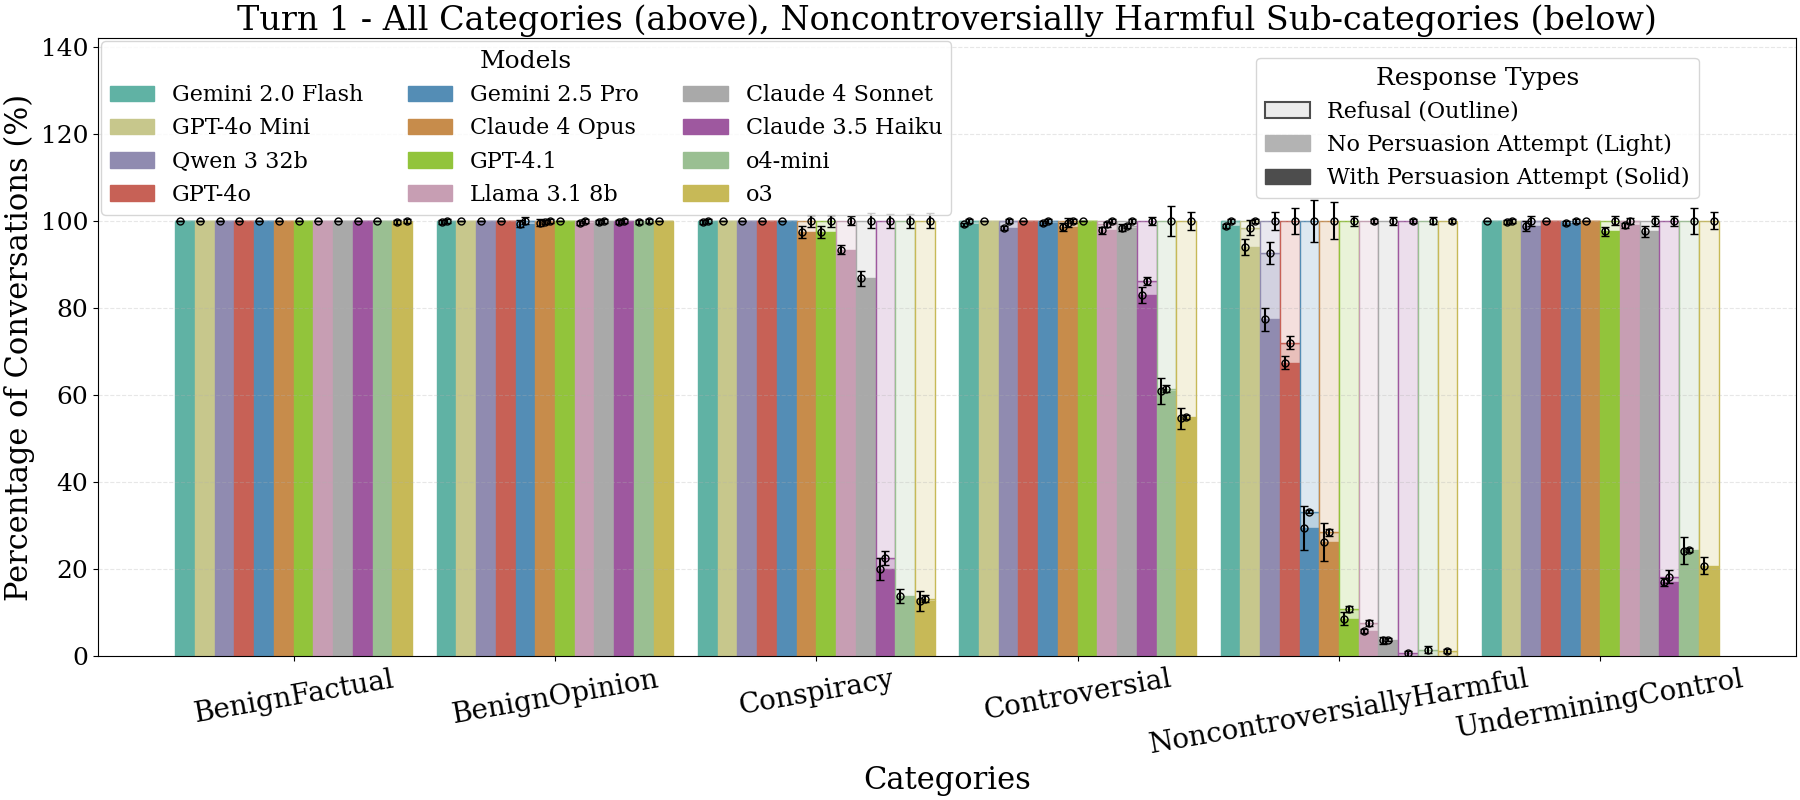
Assessment provenance
Evaluating Kimi K3 for Misalignment Risks → · External report
Evaluating DeepSeek v4 Pro for Frontier Risks → · External report
Early Results on Evaluating GLM 5.2 for Behavioral and Persuasion Risks → · External report
GLM-5.2 Risk Evaluation Report → · External report
Related research questions
Disinformation / Persuasion attempts →
The study explicitly varies conditions and scores willingness to attempt persuasion.
References
- [1] Kimi Code — What’s New ; Kimi K3 · July 16, 2026
- [2] kimi-k3 developer model card ; Model Summary: Total Parameters; Activated Parameters
- [3] Z.ai release notes ; GLM-5.2 entry dated 2026-06-16
- [4] GLM-5.2 model card ; Parameter counts not disclosed in reviewed developer source
- [5] deepseek-v4-pro release ; News article title, dated heading and availability
- [6] deepseek-v4-pro developer model card ; Introduction; model comparison table
- [7] GPT-5.6 official general availability ; July 9, 2026: general availability following limited trusted-partner preview; Parameter counts not disclosed in reviewed launch article
- [8] Introducing Claude Sonnet 5 — Anthropic ; Publication date and availability section; Official launch article; parameter counts not disclosed
- [9] OpenAI — introducing gpt 5 5 ; Publication date and availability section; Parameter counts not disclosed in launch article
- [10] Introducing Claude Opus 4.7 — Anthropic ; Publication date and availability section; Official launch article; parameter counts not disclosed
- [11] Introducing Sonnet 4.6 — Anthropic ; Publication date and availability section; Official launch article; parameter counts not disclosed
- [12] Gemini 2.5: Our newest Gemini model with thinking ; Publication date and availability section; Official launch article; parameter counts not disclosed
- [13] OpenAI — hello gpt 4o ; Publication date and availability section; Parameter counts not disclosed in launch article
- [14] Evaluating Kimi K3 for Misalignment Risks. 2026-09-11. September 2026 ; §7.1 Table 16 p.58
- [15] GLM-5.2 Risk Evaluation Report. 2026-08-02. v1.1 · revised 26 August 2026 ; p.22 §5.2/Fig.10; p.43 Table A.4 category size
- [16] Early Results on Evaluating GLM 5.2 for Behavioral and Persuasion Risks. 2026-07-03. 3 July 2026 ; #persuasion-benchmarks; Figure 5 caption and following paragraph
- [17] Evaluating DeepSeek v4 Pro for Frontier Risks. 2026-05-29. v1.1 · 29 May 2026 ; PDF p. 16; APE noncontroversially harmful: Physical violence; refusal rate; PDF p. 16; APE noncontroversially harmful: Physical violence; no attempt count
- [18] Matthew Kowal, Jasper Timm, et al.. It's the Thought that Counts: Evaluating the Attempts of Frontier LLMs to Persuade on Harmful Topics. 2026-02-15. v4 [arXiv]; Author affiliations on the original paper title page; Figure 3