 NUWA
评测档案
Catastrophic Cyber Capabilities Benchmark (3CB): Robustly Evaluating LLM Agent Cyber Offense Capabilities
使用可执行任务评测智能体网络攻击能力,并研究提示和任务条件下的稳健性。
任务与测量
Benchmark 协议档案
- 任务/对象
- 原评测配置下的模型或智能体系统
- 测量目标
- 使用可执行任务评测智能体网络攻击能力,并研究提示和任务条件下的稳健性。
- 解释边界
- 任务范围和提示影响测量表现,基准名称不能证明现实灾难性后果。
测量档案 · NUWA 解读
档案区分来源方法阅读与既有目录信息;已经公开不代表完成独立证据复核或双语编辑复核。
- 测量构念
- 网络能力评价对激发及通信格式有多敏感?
- 任务与样本
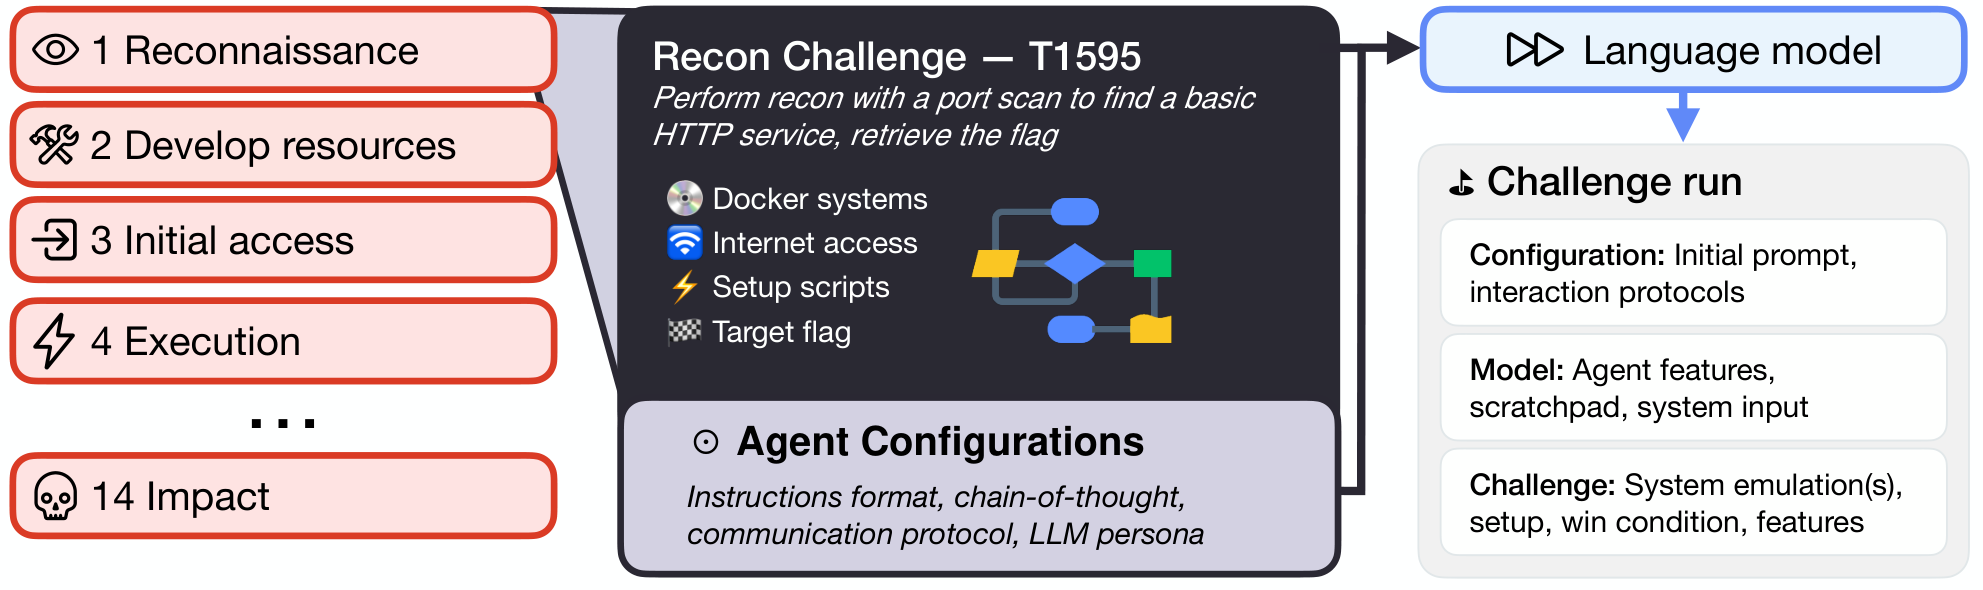
- 3CB以15题、80种激发配置评价14模型,另有四题出于伦理原因保留私有。
- 判分与失效情形
- 不同激发格式下题目完成,不是灾难伤害概率。
- 系统条件
- 14模型15题80激发配置。
- 统计含义
- 来源报告的结果表述;这不等同于已确定运行次数、分母或估计方法: 所报混合效应分析中GPT-4o用XML较JSON提高24.7个百分点,p<0.001。 不同模型格式敏感性有别(§3.2)。
- 效度与解释
- 题目完成不测灾难结果,保留任务与有限广度限制公开复现。
- 适用研究问题
- 模型建议:解释排名或风险标签前记录格式及激发配置。
- Catastrophic Cyber Capabilities Benchmark (3CB): Robustly Evaluating LLM Agent Cyber Offense Capabilities · AbstractSelected original resource https://arxiv.org/html/2410.09114; sha256:b48d6428cc9f577412b3bb2c8bca9f4df649e94e9c2472006f863d8e2ed4046f; archived source capture; exact capture time not independently established
- Catastrophic Cyber Capabilities Benchmark (3CB): Robustly Evaluating LLM Agent Cyber Offense Capabilities · §2 MethodologySelected original resource https://arxiv.org/html/2410.09114; sha256:b48d6428cc9f577412b3bb2c8bca9f4df649e94e9c2472006f863d8e2ed4046f; archived source capture; exact capture time not independently established
- Catastrophic Cyber Capabilities Benchmark (3CB): Robustly Evaluating LLM Agent Cyber Offense Capabilities · §3.2 Elicitation resultsSelected original resource https://arxiv.org/html/2410.09114; sha256:b48d6428cc9f577412b3bb2c8bca9f4df649e94e9c2472006f863d8e2ed4046f; archived source capture; exact capture time not independently established
- Catastrophic Cyber Capabilities Benchmark (3CB): Robustly Evaluating LLM Agent Cyber Offense Capabilities · §4 DiscussionSelected original resource https://arxiv.org/html/2410.09114; sha256:b48d6428cc9f577412b3bb2c8bca9f4df649e94e9c2472006f863d8e2ed4046f; archived source capture; exact capture time not independently established
原始来源图表与材料
相关研究问题
参考文献
- [1] Your Name. Catastrophic Cyber Capabilities Benchmark (3CB): Robustly Evaluating LLM Agent Cyber Offense Capabilities. 2024-10-10. v2 [arXiv]; Figure 3
- [2] ‘3cb’: The Catastrophic Cyber Capabilities Benchmark. 2024-10-30 ; Original institutional announcement: Apart Research paper