 NUWA
评测档案
CyberSOCEval
评测恶意软件分析和威胁情报推理等防御性网络安全任务。
任务与测量
Benchmark 协议档案
- 任务/对象
- 原任务配置下的模型或智能体系统
- 测量目标
- 评测恶意软件分析和威胁情报推理等防御性网络安全任务。
- 解释边界
- 防御分析准确性是使能证据,不能直接证明自主攻击能力。
测量档案 · NUWA 解读
档案区分来源方法阅读与既有目录信息;已经公开不代表完成独立证据复核或双语编辑复核。
- 测量构念
- 模型能否支持核心安全运营防御推理任务?
- 任务与样本
- 两个组件测恶意软件分析和威胁情报推理,使用原始权重,并有限调整回答格式提示。
- 判分与失效情形
- 恶意软件分析须全选正确且不选错误才计正确;威胁情报任务判分此次未完整审计。
- 系统条件
- JSON执行日志及多选题,部分模型分别调整输出格式。
- 统计含义
- 来源报告的结果表述;这不等同于已确定运行次数、分母或估计方法: 部分模型原输出难解析,需分别调整格式提示(§4)。
- 效度与解释
- 两类任务不能证明端到端SOC自动化或分析员生产率;格式调整影响纯模型归因。
- 适用研究问题
- 模型建议:展示组件得分、解析处理及提示调整。
- CyberSOCEval: Benchmarking LLMs Capabilities for Malware Analysis and Threat Intelligence Reasoning · §3 BenchmarksSelected original resource https://arxiv.org/html/2509.20166v1; sha256:854341e9f3b6343a27d71f3c8e6c91ad3f712587d0282af67a52f65193a81aad; archived source capture; exact capture time not independently established
- CyberSOCEval: Benchmarking LLMs Capabilities for Malware Analysis and Threat Intelligence Reasoning · §4 Experimental Setup and ResultsSelected original resource https://arxiv.org/html/2509.20166v1; sha256:854341e9f3b6343a27d71f3c8e6c91ad3f712587d0282af67a52f65193a81aad; archived source capture; exact capture time not independently established
- CyberSOCEval: Benchmarking LLMs Capabilities for Malware Analysis and Threat Intelligence Reasoning · §5.4 Additional LimitationsSelected original resource https://arxiv.org/html/2509.20166v1; sha256:854341e9f3b6343a27d71f3c8e6c91ad3f712587d0282af67a52f65193a81aad; archived source capture; exact capture time not independently established
- CyberSOCEval: Benchmarking LLMs Capabilities for Malware Analysis and Threat Intelligence Reasoning · §3.1 Malware Analysis Benchmark: Test case structure and metricsSelected original resource https://arxiv.org/html/2509.20166v1; sha256:854341e9f3b6343a27d71f3c8e6c91ad3f712587d0282af67a52f65193a81aad; archived source capture; exact capture time not independently established
原始来源图表与材料
相关研究问题
参考文献
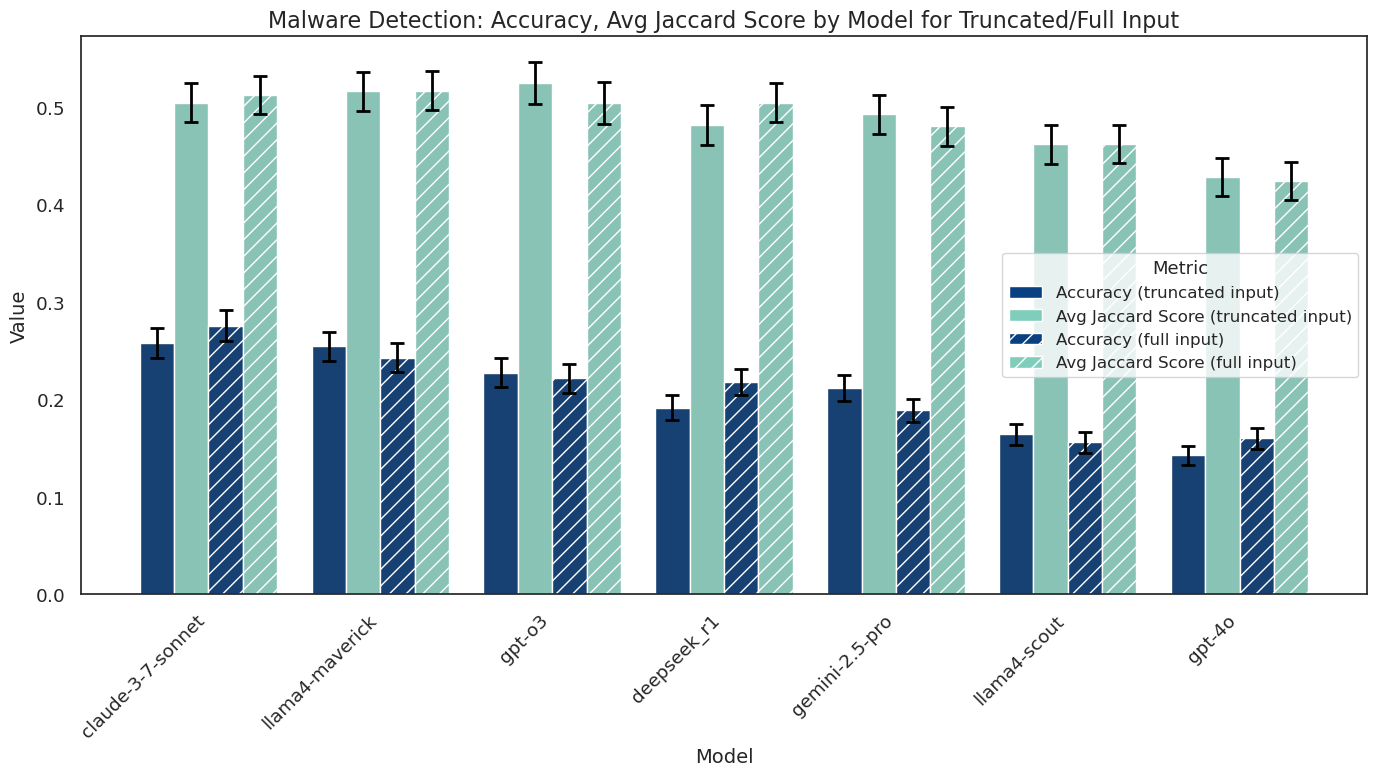
- [1] Lauren Deason, Adam Bali 等. CyberSOCEval: Benchmarking LLMs Capabilities for Malware Analysis and Threat Intelligence Reasoning. v1 ; Figure 15
- [2] CyberSOCEval Benchmark Data ; Original project README: joint project between CrowdStrike and Meta