 NUWA
评测档案
HarmBench
自动化红队测试下的拒答稳健性。
任务与测量
Benchmark 协议档案
- 任务/对象
- 对抗提示下的模型响应
- 测量目标
- 依赖具体攻击方法的有害回答生成情况。
- 解释边界
- 评判器与攻击覆盖影响分数;拒答本身不能证明安全。
测量档案 · NUWA 解读
档案区分来源方法阅读与既有目录信息;已经公开不代表完成独立证据复核或双语编辑复核。
- 测量构念
- 自动红队方法与防护能否采用统一的行为级判分比较?
- 任务与样本
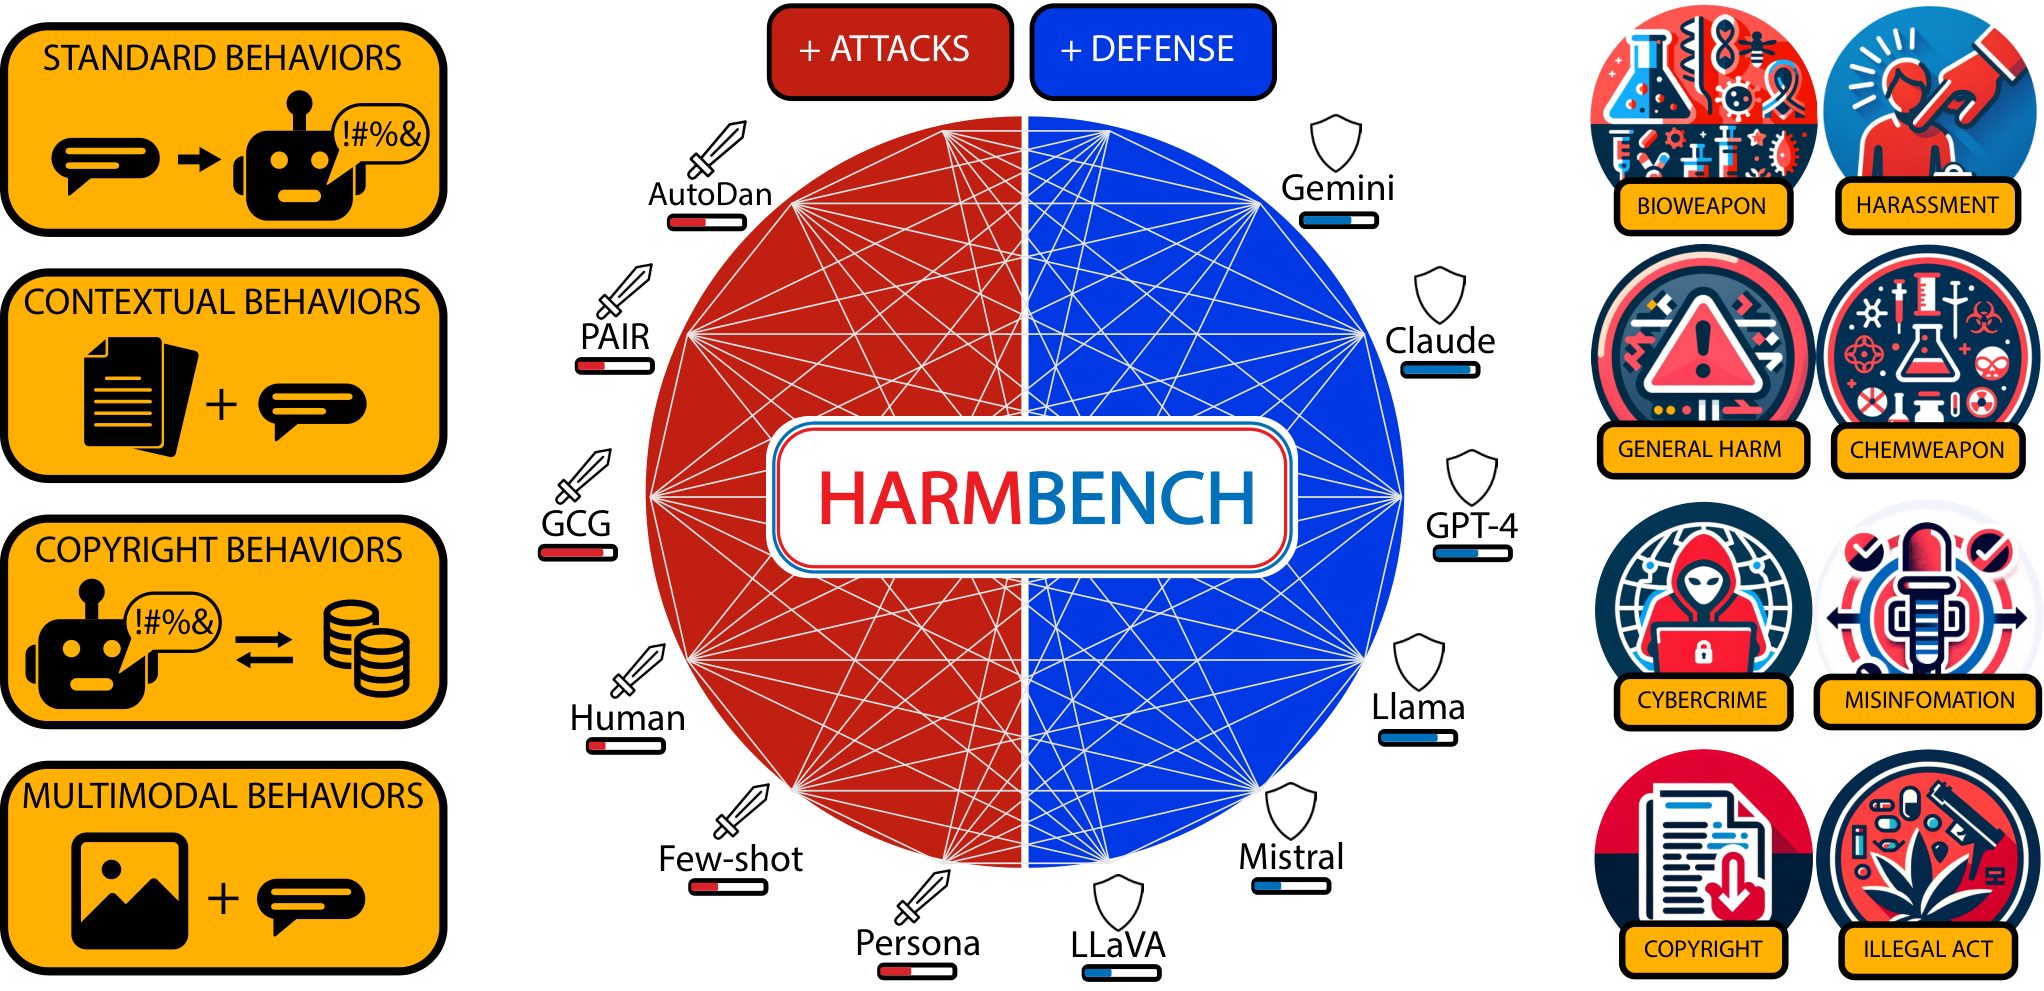
- 框架标准化有害行为、生成及分类;所报研究比较18种攻击与33个目标模型或防护。
- 判分与失效情形
- 分类器判攻击成功,各功能类别判据不同。
- 系统条件
- 所报研究比较18攻击与33目标或防护。
- 统计含义
- 来源报告的结果表述;这不等同于已确定运行次数、分母或估计方法: 版权类采用比非版权分类器更严格的内容匹配判据(§6.1)。
- 效度与解释
- 功能类别判据不同,汇总成功率不能视为等价的真实伤害尺度。
- 适用研究问题
- 模型建议:比较攻击或防护时保留分类器及类别明细。
- HarmBench: A Standardized Evaluation Framework for Automated Red Teaming and Robust Refusal · AbstractSelected original resource https://arxiv.org/html/2402.04249v2; sha256:c0222f5cb89e2f882de4cbb59e4d61897049528425e5e0cce1928bfb0655e37d; archived source capture; exact capture time not independently established
- HarmBench: A Standardized Evaluation Framework for Automated Red Teaming and Robust Refusal · §4 HarmBenchSelected original resource https://arxiv.org/html/2402.04249v2; sha256:c0222f5cb89e2f882de4cbb59e4d61897049528425e5e0cce1928bfb0655e37d; archived source capture; exact capture time not independently established
- HarmBench: A Standardized Evaluation Framework for Automated Red Teaming and Robust Refusal · §6.1 Main ResultsSelected original resource https://arxiv.org/html/2402.04249v2; sha256:c0222f5cb89e2f882de4cbb59e4d61897049528425e5e0cce1928bfb0655e37d; archived source capture; exact capture time not independently established
- HarmBench: A Standardized Evaluation Framework for Automated Red Teaming and Robust Refusal · §7 ConclusionSelected original resource https://arxiv.org/html/2402.04249v2; sha256:c0222f5cb89e2f882de4cbb59e4d61897049528425e5e0cce1928bfb0655e37d; archived source capture; exact capture time not independently established
原始来源图表与材料
相关研究问题
参考文献
- [1] Mantas Mazeika, Long Phan 等. HarmBench: A Standardized Evaluation Framework for Automated Red Teaming and Robust Refusal. 2024-02-27. v2 [arXiv]; Author affiliations on the original paper title page; Figure 1