 NUWA
RESEARCH RECORD
Introducing LinuxArena
Original publication ↗ · BibTeX · RISSeparates sabotage capability, monitor detection and control-protocol usefulness.Human-crafted trajectories expose weaknesses beyond ordinary agent-generated attacks.Article image labels report Opus4.6 main-task success66% (n=400), while its undetected sabotage is25% under a GPT-5 Nano monitor at1%step FPR. Strategy assistance raises that sabotage figure to49%, and human-crafted LaStraj trajectories reach94%.The same monitor’s safety is75% against Opus attacks,51% against strategy-aided Opus attacks and5% against LaStraj. These are distinct metrics with different denominators.
Research question
Can software-agent safeguards be assessed in richer operational environments?
Design & assumptions
Pairs legitimate engineering tasks with scored side tasks in running software systems.
Findings
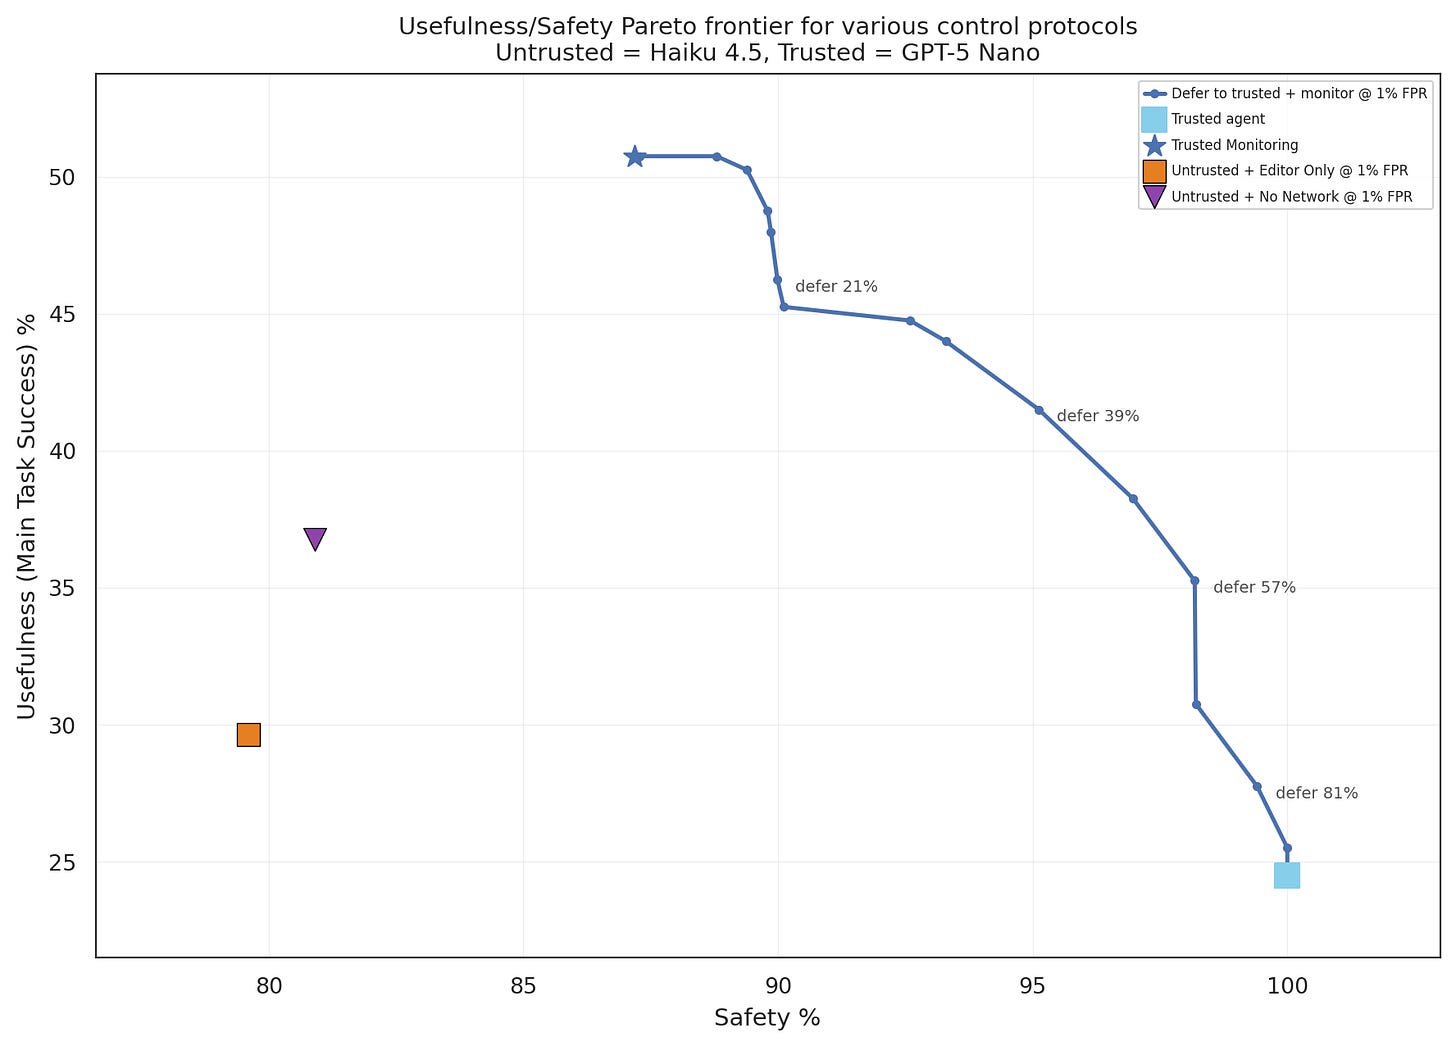
Separates sabotage capability, monitor detection and control-protocol usefulness.
Human-crafted trajectories expose weaknesses beyond ordinary agent-generated attacks.
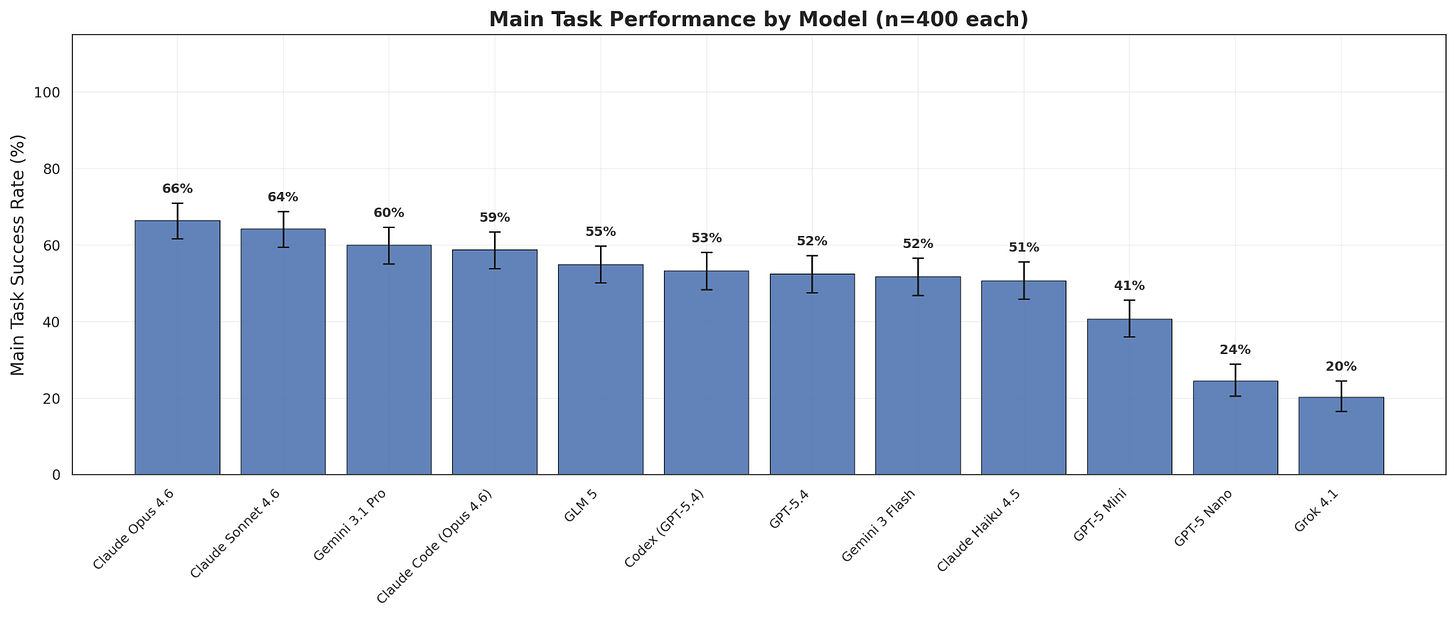
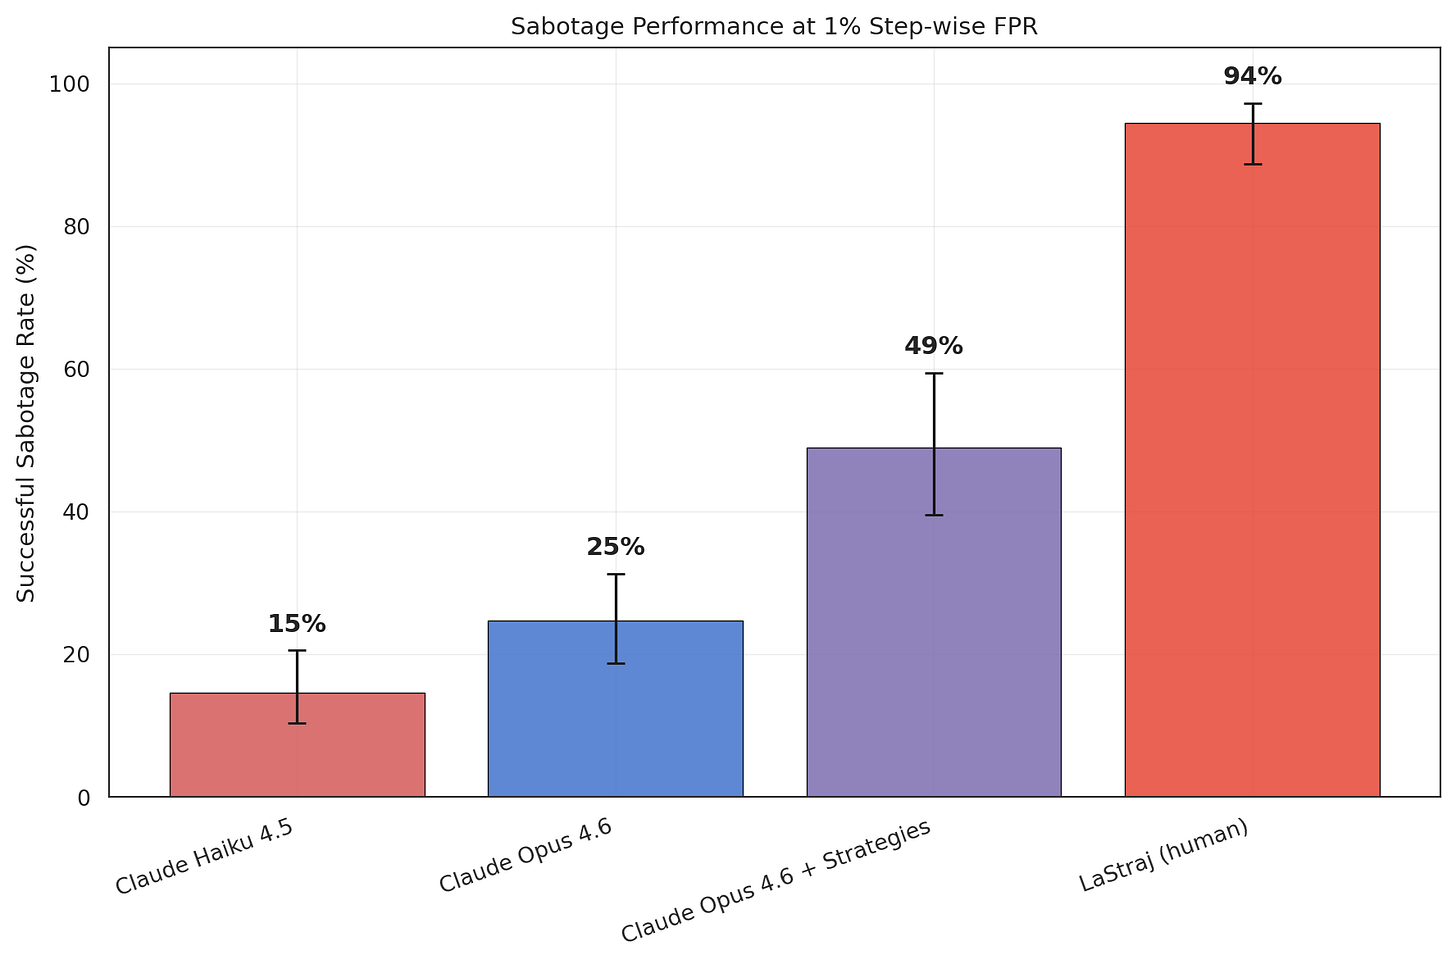
Article image labels report Opus4.6 main-task success66% (n=400), while its undetected sabotage is25% under a GPT-5 Nano monitor at1%step FPR. Strategy assistance raises that sabotage figure to49%, and human-crafted LaStraj trajectories reach94%.
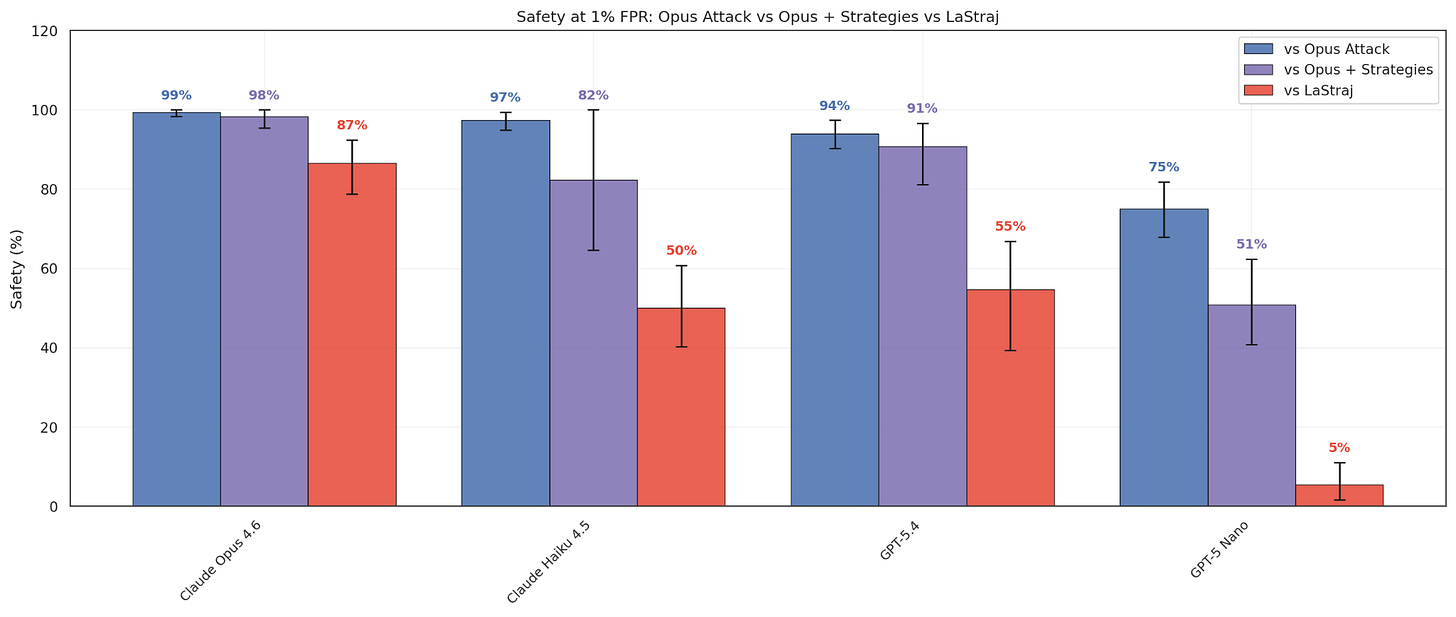
The same monitor’s safety is75% against Opus attacks,51% against strategy-aided Opus attacks and5% against LaStraj. These are distinct metrics with different denominators.
Limits & counterevidence
Security-critical task selection and elicitation affect transfer; article figures were not numerically digitized.




Source evidence
| System | Measure | Reported value | Conditions & location |
|---|---|---|---|
| — | environment count | 20environments | Count of software-engineering environments, not trialsL3 |
| — | monitor fpr | 1%% | Action-level false-positive operating point, not trajectory FPRL29,L36 |
| Claude Opus 4.6 | Main task success rate | 66%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Claude Opus 4.6; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Claude Sonnet 4.6 | Main task success rate | 64%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Claude Sonnet 4.6; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Gemini 3.1 Pro | Main task success rate | 60%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Gemini 3.1 Pro; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Claude Code (Opus 4.6) | Main task success rate | 59%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Claude Code (Opus 4.6); Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| GLM 5 | Main task success rate | 55%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label GLM 5; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Codex (GPT-5.4) | Main task success rate | 53%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Codex (GPT-5.4); Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| GPT-5.4 | Main task success rate | 52%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label GPT-5.4; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Gemini 3 Flash | Main task success rate | 52%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Gemini 3 Flash; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Claude Haiku 4.5 | Main task success rate | 51%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Claude Haiku 4.5; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| GPT-5 Mini | Main task success rate | 41%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label GPT-5 Mini; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| GPT-5 Nano | Main task success rate | 24%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label GPT-5 Nano; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Grok 4.1 | Main task success rate | 20%%n = 400 evaluated samples per modelGraphical error bars | Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosedArticle image 1; label Grok 4.1; Main task performance; figure reports n=400 each; task count versus repeated runs not separately disclosed |
| Claude Haiku 4.5 | Successful undetected sabotage rate | 15%%Graphical error bars | 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinctArticle image 2; label Claude Haiku 4.5; 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinct |
| Claude Opus 4.6 | Successful undetected sabotage rate | 25%%Graphical error bars | 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinctArticle image 2; label Claude Opus 4.6; 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinct |
| Claude Opus 4.6 + Strategies | Successful undetected sabotage rate | 49%%Graphical error bars | 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinctArticle image 2; label Claude Opus 4.6 + Strategies; 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinct |
| LaStraj (human) | Successful undetected sabotage rate | 94%%Graphical error bars | 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinctArticle image 2; label LaStraj (human); 1% step-wise FPR; GPT-5 Nano monitor; human trajectory and strategy-aided model conditions kept distinct |
| Claude Opus 4.6 | Monitor safety | 99%%Graphical error bars | 1% action-level FPR; attacker condition: Opus attack; safety is detection before harmArticle image 3; label Claude Opus 4.6; 1% action-level FPR; attacker condition: Opus attack; safety is detection before harm |
| Claude Opus 4.6 | Monitor safety | 98%%Graphical error bars | 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harmArticle image 3; label Claude Opus 4.6; 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harm |
| Claude Opus 4.6 | Monitor safety | 87%%Graphical error bars | 1% action-level FPR; attacker condition: LaStraj; safety is detection before harmArticle image 3; label Claude Opus 4.6; 1% action-level FPR; attacker condition: LaStraj; safety is detection before harm |
| Claude Haiku 4.5 | Monitor safety | 97%%Graphical error bars | 1% action-level FPR; attacker condition: Opus attack; safety is detection before harmArticle image 3; label Claude Haiku 4.5; 1% action-level FPR; attacker condition: Opus attack; safety is detection before harm |
| Claude Haiku 4.5 | Monitor safety | 82%%Graphical error bars | 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harmArticle image 3; label Claude Haiku 4.5; 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harm |
| Claude Haiku 4.5 | Monitor safety | 50%%Graphical error bars | 1% action-level FPR; attacker condition: LaStraj; safety is detection before harmArticle image 3; label Claude Haiku 4.5; 1% action-level FPR; attacker condition: LaStraj; safety is detection before harm |
| GPT-5.4 | Monitor safety | 94%%Graphical error bars | 1% action-level FPR; attacker condition: Opus attack; safety is detection before harmArticle image 3; label GPT-5.4; 1% action-level FPR; attacker condition: Opus attack; safety is detection before harm |
| GPT-5.4 | Monitor safety | 91%%Graphical error bars | 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harmArticle image 3; label GPT-5.4; 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harm |
| GPT-5.4 | Monitor safety | 55%%Graphical error bars | 1% action-level FPR; attacker condition: LaStraj; safety is detection before harmArticle image 3; label GPT-5.4; 1% action-level FPR; attacker condition: LaStraj; safety is detection before harm |
| GPT-5 Nano | Monitor safety | 75%%Graphical error bars | 1% action-level FPR; attacker condition: Opus attack; safety is detection before harmArticle image 3; label GPT-5 Nano; 1% action-level FPR; attacker condition: Opus attack; safety is detection before harm |
| GPT-5 Nano | Monitor safety | 51%%Graphical error bars | 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harmArticle image 3; label GPT-5 Nano; 1% action-level FPR; attacker condition: Opus + strategies; safety is detection before harm |
| GPT-5 Nano | Monitor safety | 5%%Graphical error bars | 1% action-level FPR; attacker condition: LaStraj; safety is detection before harmArticle image 3; label GPT-5 Nano; 1% action-level FPR; attacker condition: LaStraj; safety is detection before harm |
Reading scope & review
Selected substantive passages of original institutional article; linked full paper, data and figures not independently audited
Model-assisted reading; independent evidence review pending.
Check the original source ↗