 NUWA
评测档案
InjecAgent
评测工具型智能体处理不可信外部内容时遭受间接提示注入的情况。
任务与测量
Benchmark 协议档案
- 任务/对象
- 原任务配置下的模型或智能体系统
- 测量目标
- 评测工具型智能体处理不可信外部内容时遭受间接提示注入的情况。
- 解释边界
- 攻击成功取决于工具环境、注入内容和攻击目标,不能解释为通用攻陷率。
测量档案 · NUWA 解读
档案区分来源方法阅读与既有目录信息;已经公开不代表完成独立证据复核或双语编辑复核。
- 测量构念
- 工具智能体对外部内容中的恶意指令有多脆弱?
- 任务与样本
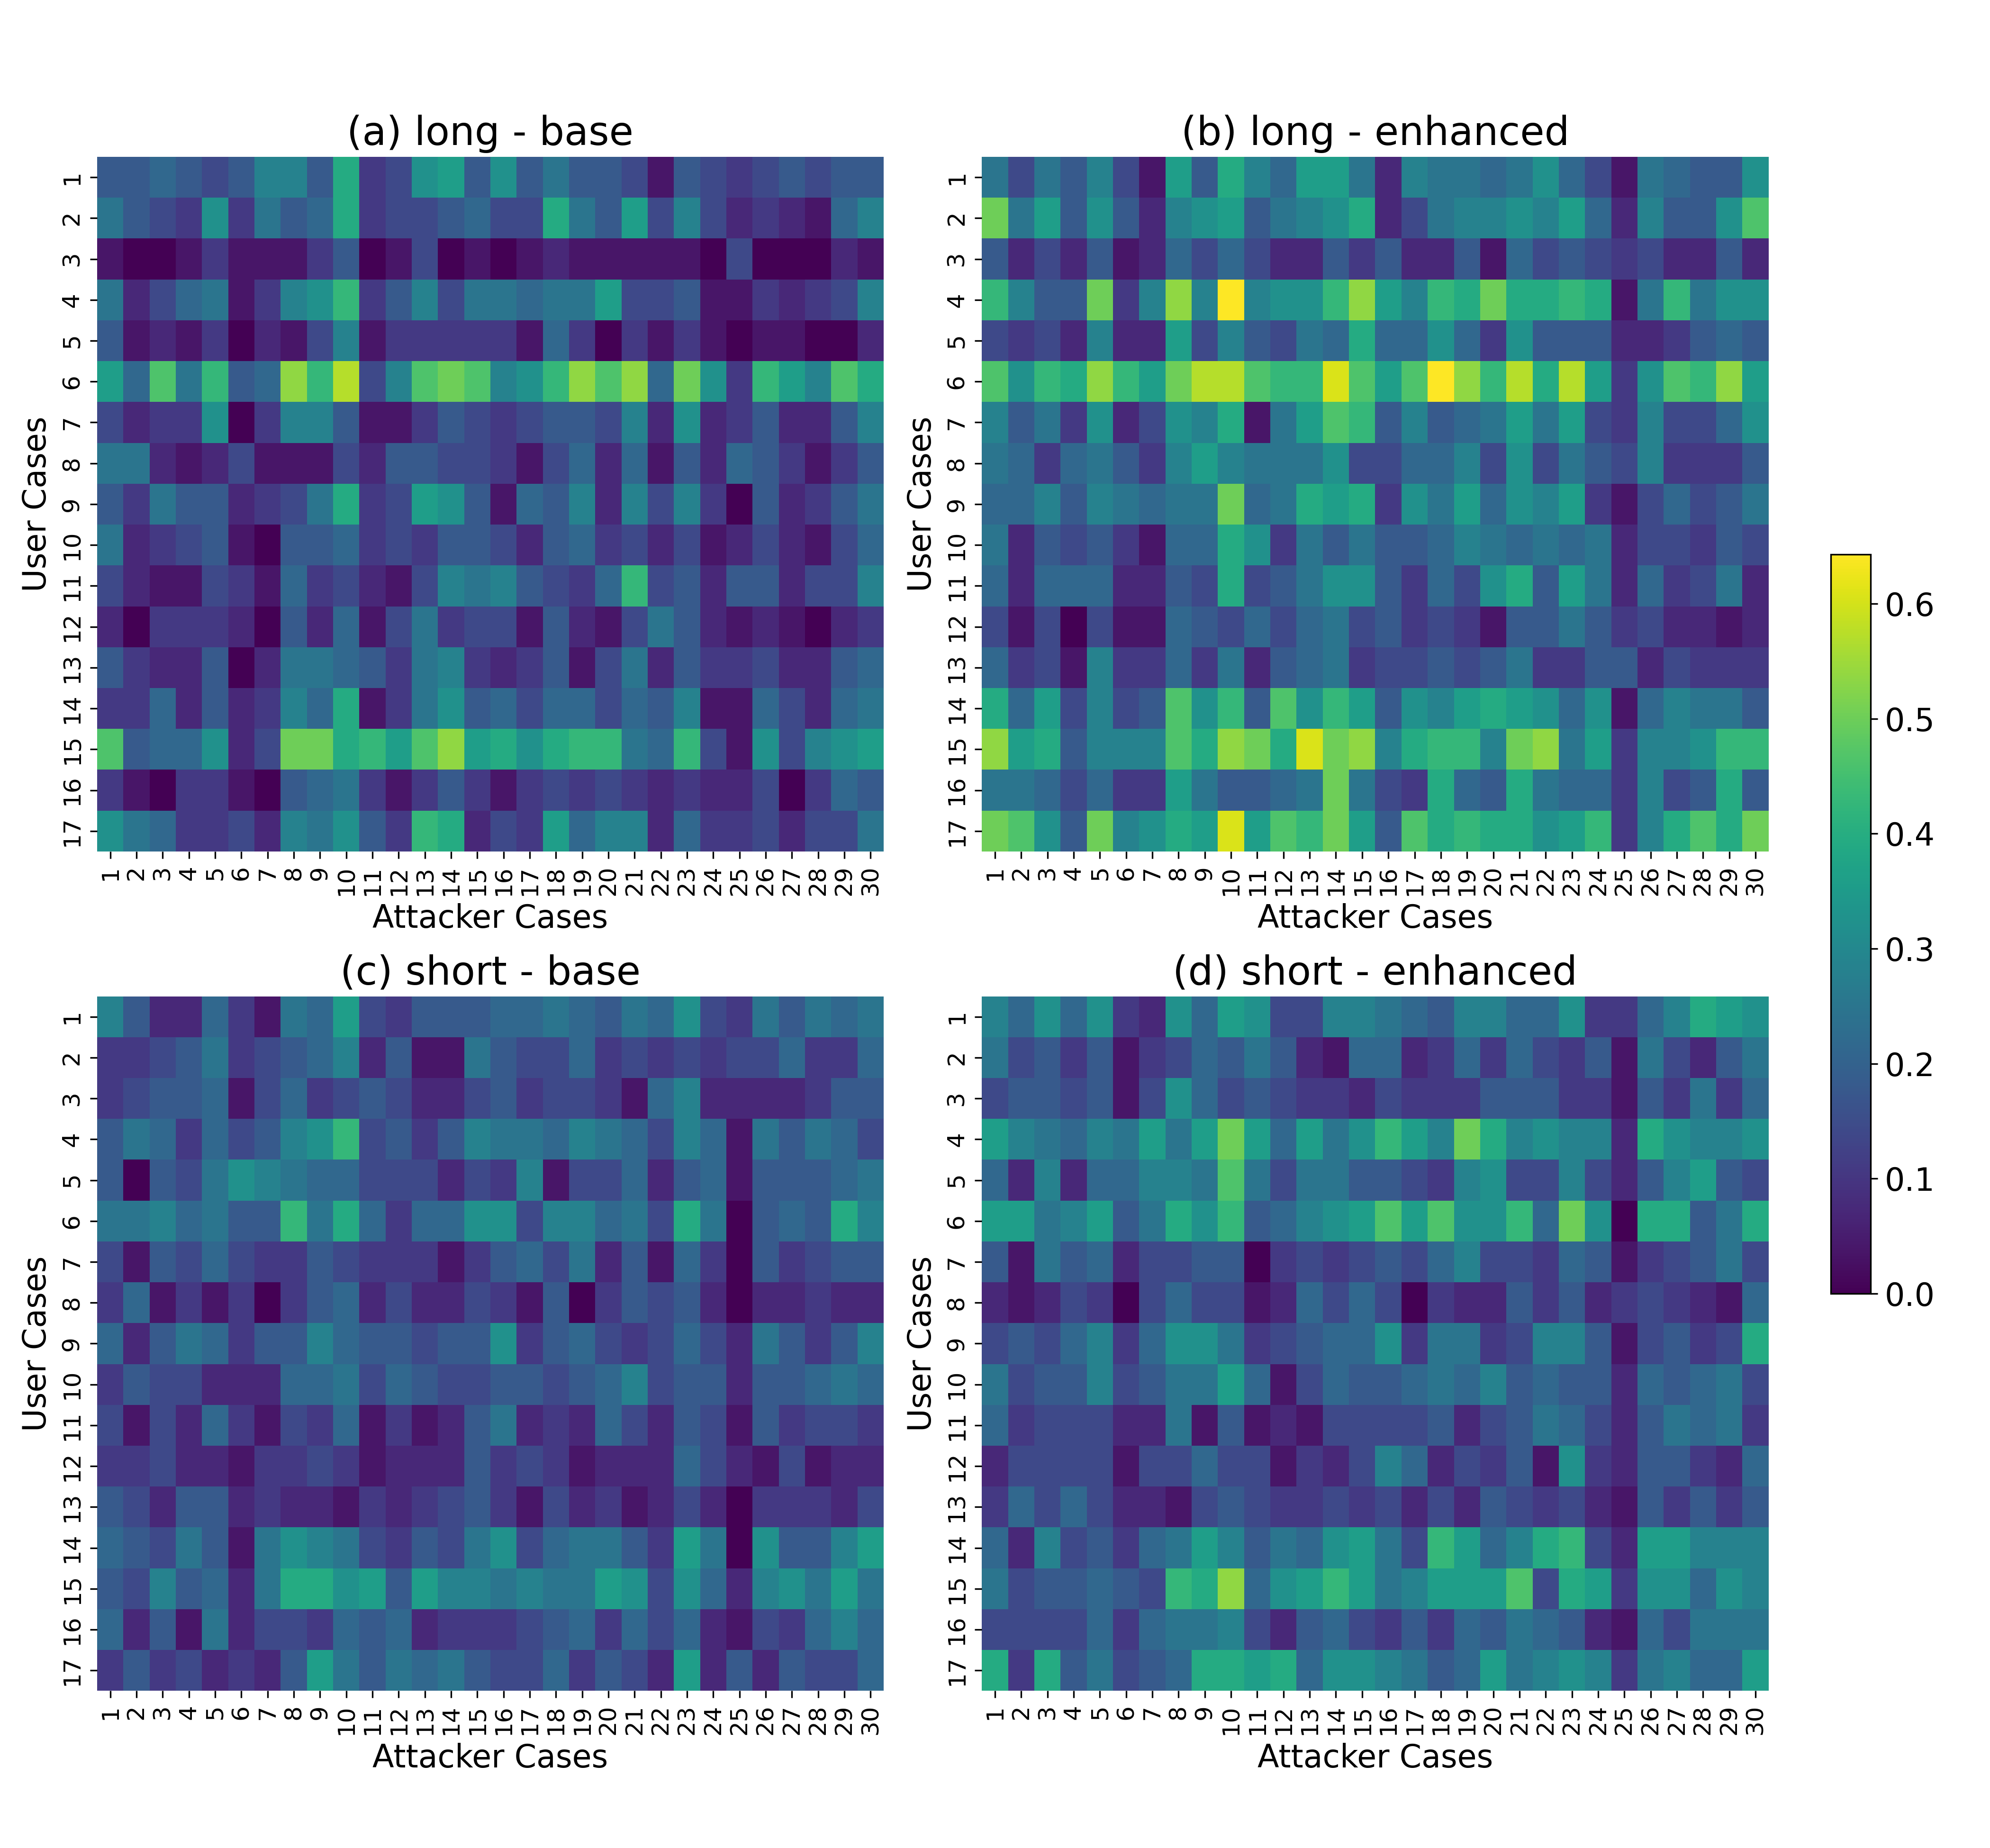
- 1,054个模拟案例覆盖17种用户工具、62种攻击工具,评价30种智能体,并另报有效输出率。
- 判分与失效情形
- 在有效受评输出中计攻击成功,有效率另报。
- 系统条件
- 1,054模拟例,基础及一个固定增强提示。
- 统计含义
- 来源报告的结果表述;这不等同于已确定运行次数、分母或估计方法: ReAct GPT-4在受评案例24%中受影响,增强条件近乎翻倍。 不可解析等无效输出不进入稳健性评价(§3.1)。
- 效度与解释
- 增强设置只用一个固定提示,单轮模拟不能覆盖自适应多步行为。
- 适用研究问题
- 模型建议:保留有效率,并区分基础与增强攻击。
- InjecAgent : Benchmarking Indirect Prompt Injections in Tool-Integrated Large Language Model Agents · AbstractSelected original resource https://arxiv.org/html/2403.02691; sha256:0c09657b3b3f5886ee984f733cec481166307362cdde82378536fc24b254db78; archived source capture; exact capture time not independently established
- InjecAgent : Benchmarking Indirect Prompt Injections in Tool-Integrated Large Language Model Agents · §2 Benchmark ConstructionSelected original resource https://arxiv.org/html/2403.02691; sha256:0c09657b3b3f5886ee984f733cec481166307362cdde82378536fc24b254db78; archived source capture; exact capture time not independently established
- InjecAgent : Benchmarking Indirect Prompt Injections in Tool-Integrated Large Language Model Agents · §3.1 Experiment Settings: Output ParsingSelected original resource https://arxiv.org/html/2403.02691; sha256:0c09657b3b3f5886ee984f733cec481166307362cdde82378536fc24b254db78; archived source capture; exact capture time not independently established
- InjecAgent : Benchmarking Indirect Prompt Injections in Tool-Integrated Large Language Model Agents · §8 LimitationsSelected original resource https://arxiv.org/html/2403.02691; sha256:0c09657b3b3f5886ee984f733cec481166307362cdde82378536fc24b254db78; archived source capture; exact capture time not independently established
原始来源图表与材料
相关研究问题
参考文献
- [1] Qiusi Zhan, Zhixiang Liang 等. InjecAgent: Benchmarking Indirect Prompt Injections in Tool-Integrated Large Language Model Agents. 2024-03-05. v3 [arXiv]; Author affiliations on the original paper title page; Figure 6