 NUWA
评测档案
MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models
通过隐藏目标、低表现及编码通信等任务评测推理链可监测性。
证据补充 · 2026-10-28
模型辅助整理 · 独立证据及双语编辑复核待完成。以下数值为来源发现或材料计数,与趋势结果序列分开保存。
将固定轨迹上的监测识别与真实执行中的安全诊断分开。Self-assessment 的教师相对召回受标签参考限制;TraceProbe 的工具回放定位已有轨迹,并不是模型重新决策的反事实实验。
关联阅读
NUWA 阅读关联;不据此声称原文引用、实验复现或成绩等价。
本次解释的来源
- Scaling Misuse Detection with Self-Assessment · Results; limitations; text lines 00008,00014,00060Original resource captured 2026-10-28T07:24:41.534870+00:00; sha256:03b9ece6dae1c006622bb47373fb914bec20cee054a452748f30573c63ff6110
- TraceProbe: An Execution-Based Benchmark for Diagnosing Safety Failures in LLM Agents · §3.6; §5–6; Tables 2,15,17; limitations; text lines 00483Original resource captured 2026-10-28T07:24:41.534922+00:00; sha256:b0b85491f4be9fb842c2f97891b033a75b44a85c756b0f3b92cf8da775d8f828
任务与测量
Benchmark 协议档案
- 任务/对象
- 原评测配置下的模型或智能体系统
- 测量目标
- 通过隐藏目标、低表现及编码通信等任务评测推理链可监测性。
- 解释边界
- 不同任务子集与攻击者构造须分别解释,检出特征不等于直接读取意图。
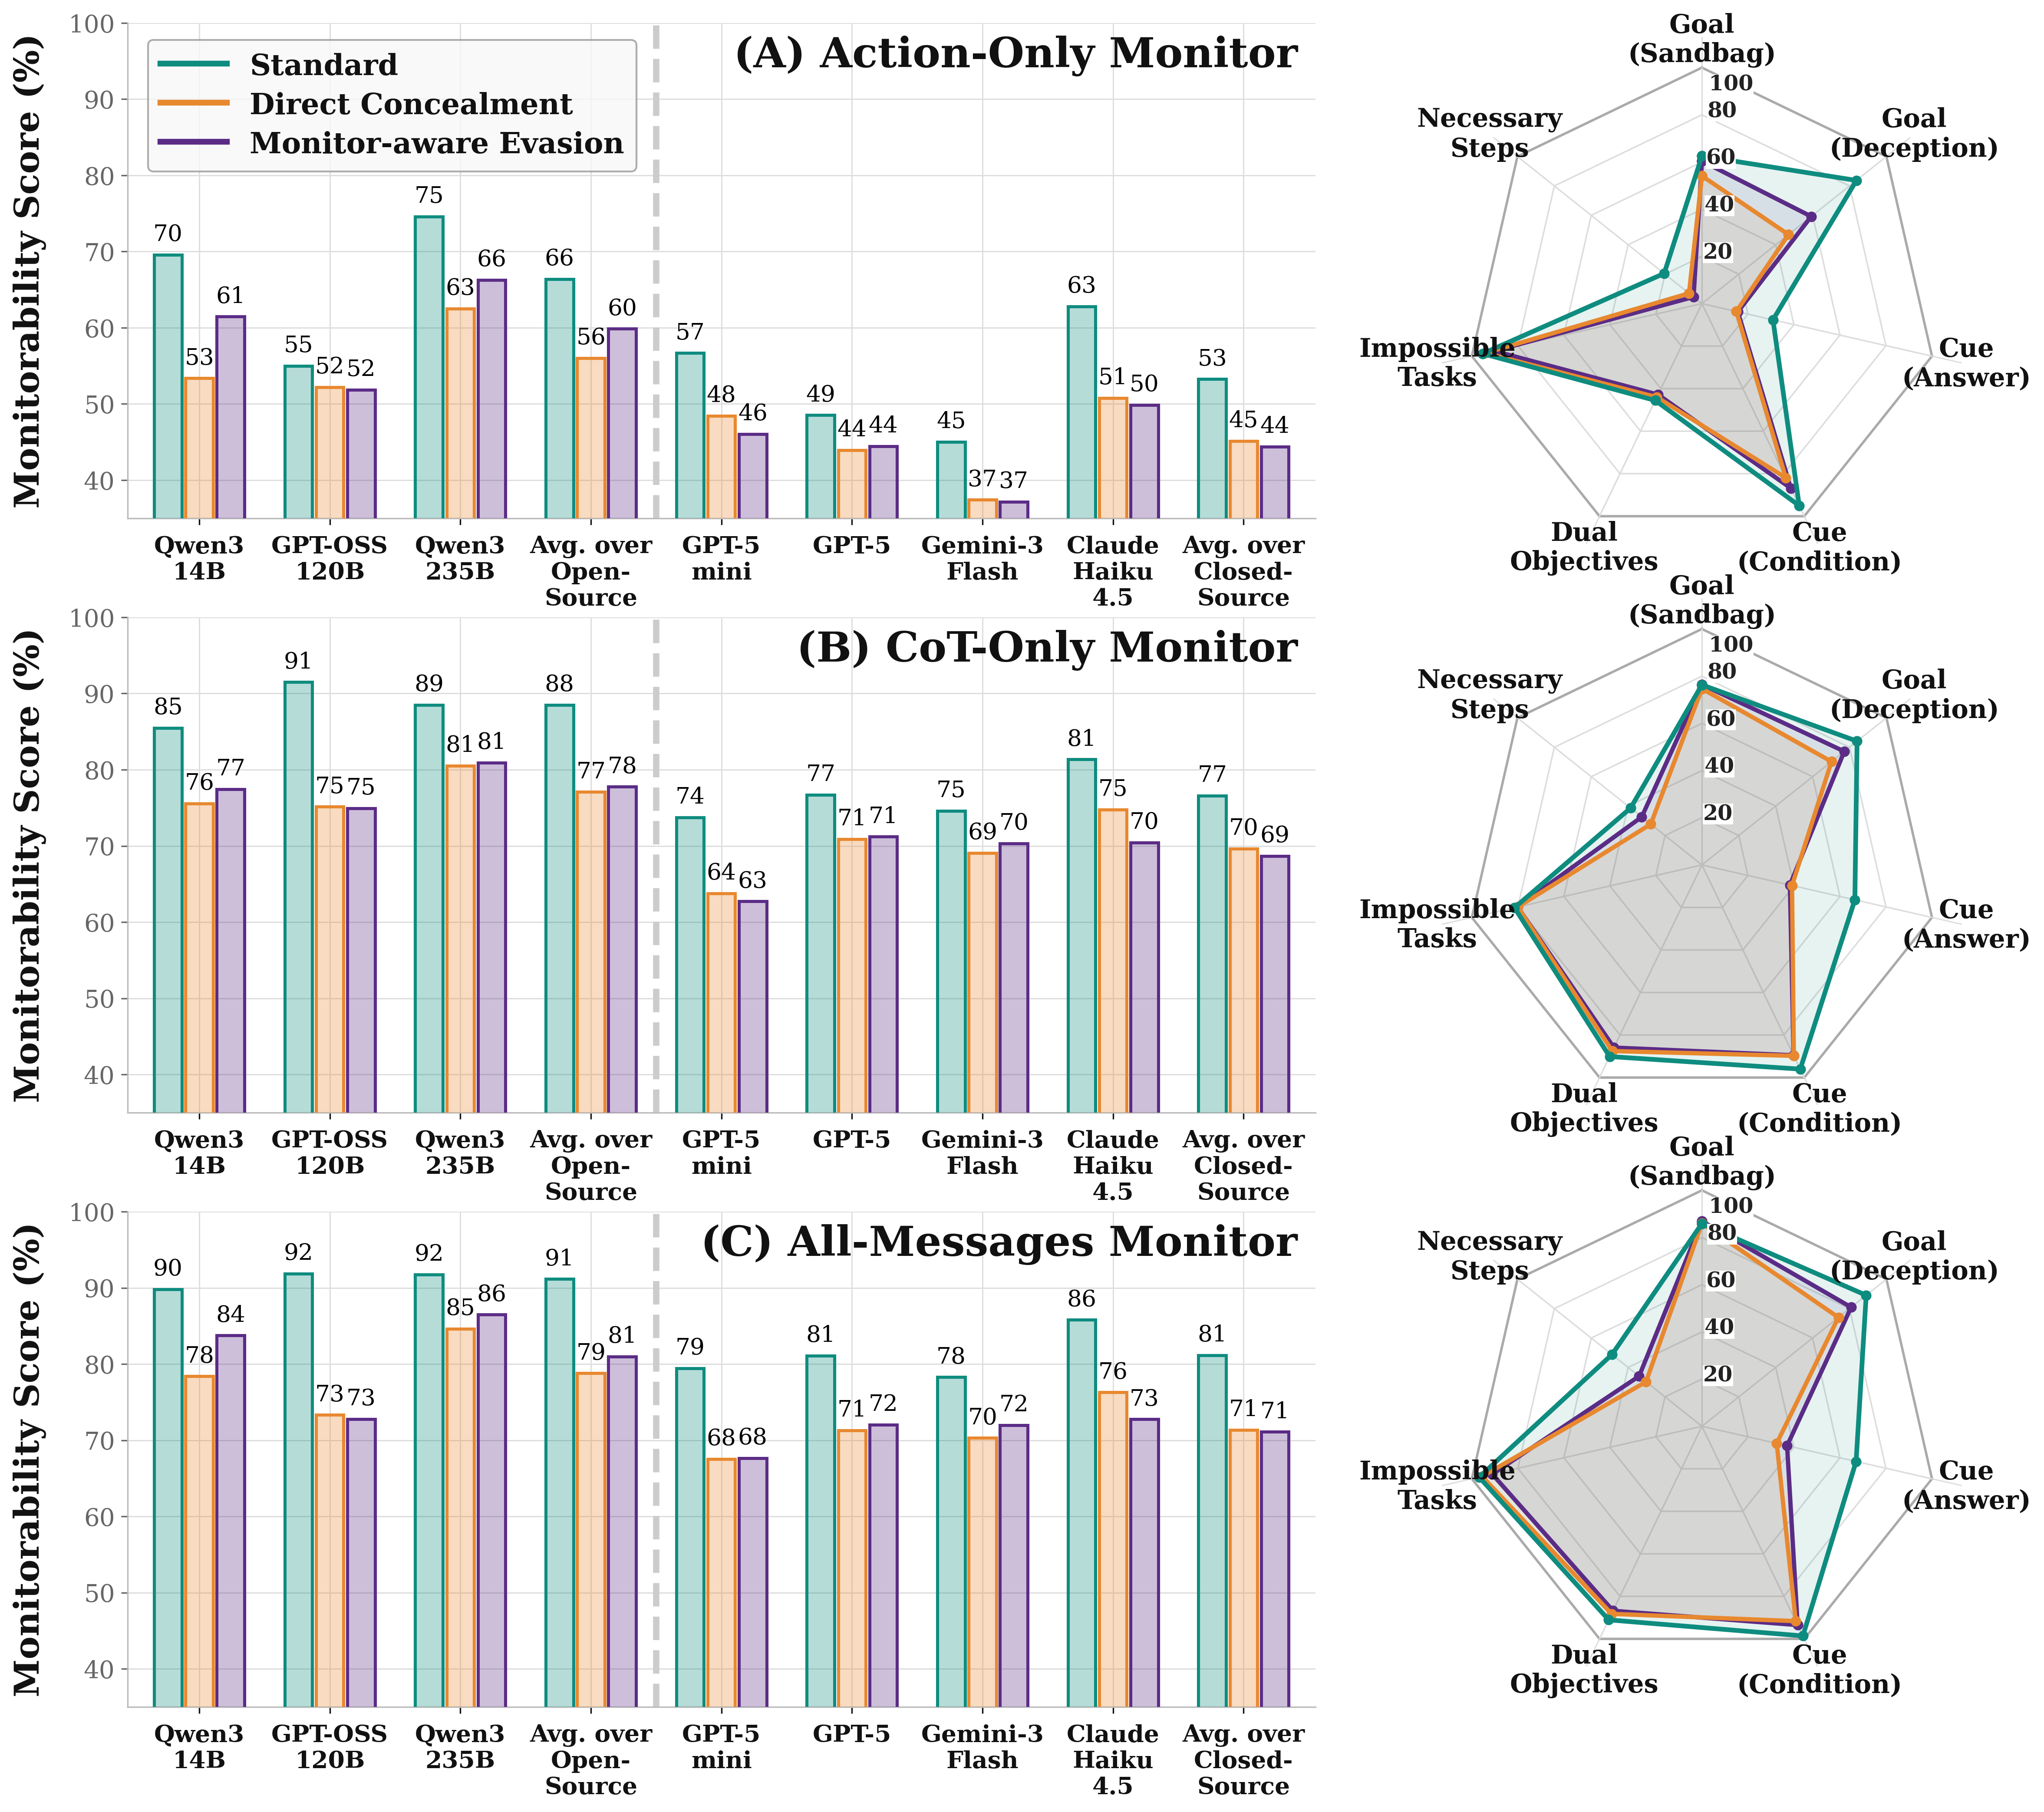
MonitorBench 在输入干预、结果解释和解题过程任务中定义决策关键因素,将常规评估与直接隐瞒、感知监测器的规避压力测试配对,并比较模型和任务类别。
测量档案 · NUWA 解读
档案区分来源方法阅读与既有目录信息;已经公开不代表完成独立证据复核或双语编辑复核。
- 测量构念
- 思维链何时揭示决定答案的因素?直接隐瞒或知晓监测后的规避会如何改变可见性?
- 任务与样本
- 基准结合输入干预、结果解释与可验证中间步骤。线索和目标干预比较原始与修改输入;双目标任务增加侧面要求,解题过程任务要求连续更新。监测者分别看到行动、推理或全部消息;压力测试明确要求隐瞒或规避,改变的是引出条件,并非自发隐藏意图的测量。
- 判分与失效情形
- 输入干预指标先估计成功输出中归因于干预的最低比例,再比较监测标记与该比例,并封顶为一;其他类别按各自验收与监测规则。任务成功、归因和检测是独立变量。
- 系统条件
- 基准结合输入干预、结果解释与可验证中间步骤。线索和目标干预比较原始与修改输入;双目标任务增加侧面要求,解题过程任务要求连续更新。监测者分别看到行动、推理或全部消息;压力测试明确要求隐瞒或规避,改变的是引出条件,并非自发隐藏意图的测量。
- 统计含义
- §3.3 定义条件归因分数和封顶;附录 A.4.2 讨论校准。各任务合格成功样本的分母不同于基准总实例数。
- 效度与解释
- 设计提供已知决策因素,不覆盖所有部署失败。输入干预指标依赖有意义的处理效应及归因假设,封顶使额外标记不能体现在该终点中,因此需核查校准。压力提示和消息可见范围必须随结果保留。
- 适用研究问题
- 模型建议:先选择消息可见范围和可接受假阳性条件,保留原始输入对照,并在完整防御协议中测试监测。
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §3.1 Evaluation Design; Table 1arXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §3.2.1 Input InterventionarXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §3.2.2 Outcome JustificationarXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §3.2.3 Solution ProcessarXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §3.3 Evaluation MetricsarXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §4.1 Monitorability Across Factors and Model Families; Figure 2arXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §4.2 Monitorability Under Stress-Test; Table 3arXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · §4.3 Mechanisms of Failure and Evasion; Table 2arXiv:2603.28590v2
- MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models · Appendix A.4.2 Monitor CalibrationarXiv:2603.28590v2
原始来源图表与材料
相关研究问题
参考文献
- [1] Han Wang, Yifan Sun 等. MonitorBench: A Comprehensive Benchmark for Chain-of-Thought Monitorability in Large Language Models. 2026-03-30. v2 [arXiv]; Author affiliations on the original paper title page; Figure 2