 NUWA
评测档案
RE-Bench
时间预算约束下的研究工程表现。
任务与测量
Benchmark 协议档案
- 任务/对象
- 执行机器学习研究工程任务的 AI 智能体
- 测量目标
- 相对于人类专家的机器学习研究工程成果。
- 解释边界
- AI 研发表现属于促成能力,不构成有害自我改进证据。
测量档案 · NUWA 解读
档案区分来源方法阅读与既有目录信息;已经公开不代表完成独立证据复核或双语编辑复核。
- 测量构念
- 开放式机器学习研究工程中,智能体与专家表现如何?
- 任务与样本
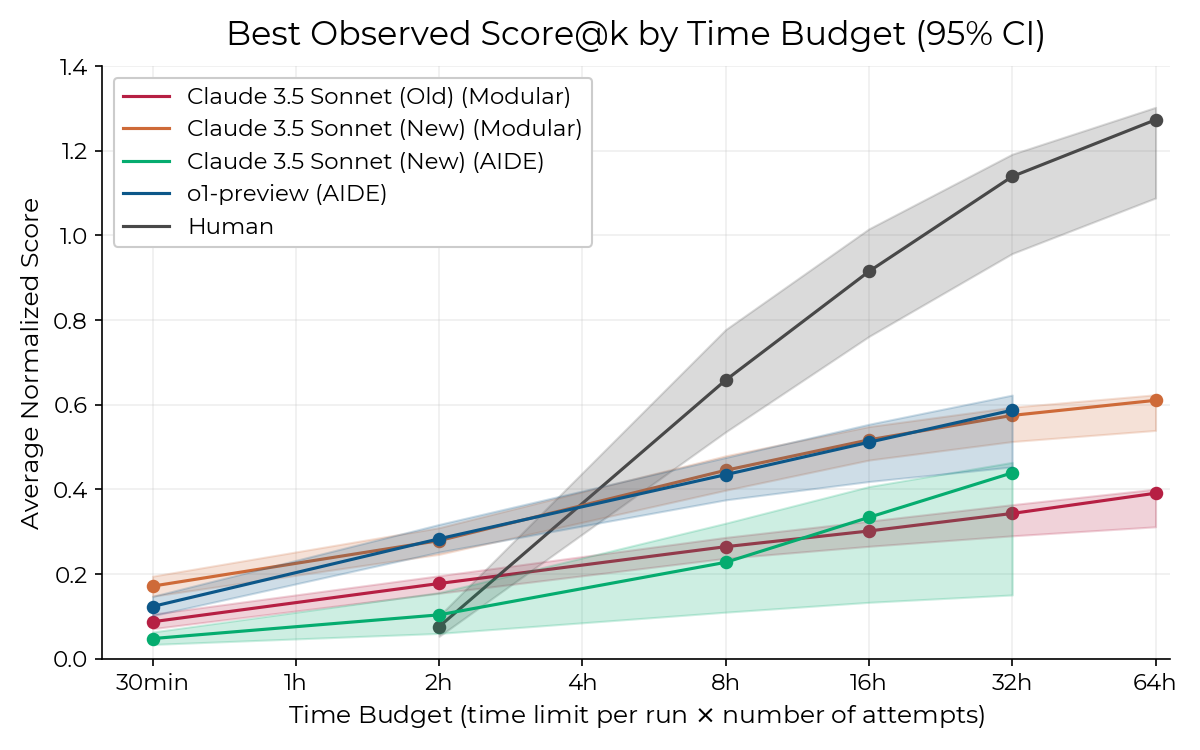
- 七个环境收集61位专家的71次八小时尝试;比较改变总时间、框架和最佳样本选择。
- 判分与失效情形
- 环境特定归一化研究工程分,比较总时间及最佳样本。
- 系统条件
- 七环境、多框架与时间预算;71次专家八小时尝试。
- 统计含义
- 来源报告的结果表述;这不等同于已确定运行次数、分母或估计方法: 82%的专家尝试得分非零,24%达到或超过参考解。 两小时条件下智能体领先,32小时累计条件下人类约为最佳智能体得分两倍。
- 效度与解释
- 七个环境不能覆盖前沿研发;有限框架迭代可能低估智能体能力(§6.3)。
- 适用研究问题
- 模型建议:同时引用归一化得分、框架、总时间及尝试聚合方式。
- RE-Bench: Evaluating frontier AI R&D capabilities of language model agents against human experts · AbstractSelected original resource https://arxiv.org/html/2411.15114v2; sha256:4a4df1346307f7b31e65c6c0e8b5533d0a6649904ea600d5b0d4d893a5d64c58; archived source capture; exact capture time not independently established
- RE-Bench: Evaluating frontier AI R&D capabilities of language model agents against human experts · §3.1 Design goalsSelected original resource https://arxiv.org/html/2411.15114v2; sha256:4a4df1346307f7b31e65c6c0e8b5533d0a6649904ea600d5b0d4d893a5d64c58; archived source capture; exact capture time not independently established
- RE-Bench: Evaluating frontier AI R&D capabilities of language model agents against human experts · §4 Experiments and resultsSelected original resource https://arxiv.org/html/2411.15114v2; sha256:4a4df1346307f7b31e65c6c0e8b5533d0a6649904ea600d5b0d4d893a5d64c58; archived source capture; exact capture time not independently established
- RE-Bench: Evaluating frontier AI R&D capabilities of language model agents against human experts · §6.3 Other LimitationsSelected original resource https://arxiv.org/html/2411.15114v2; sha256:4a4df1346307f7b31e65c6c0e8b5533d0a6649904ea600d5b0d4d893a5d64c58; archived source capture; exact capture time not independently established
原始来源图表与材料
相关研究问题
自主性 / 持续自主任务 →
来源测量前提能力,并未观察到对应风险行为。
参考文献
- [1] Hjalmar Wijk, Tao Lin 等. RE-Bench: Evaluating frontier AI R&D capabilities of language model agents against human experts. 2025-05-27. v2 [arXiv]; Author affiliations on the original paper title page; Figure 2