 NUWA
评测档案
SEC-bench
通过自动构建的可执行软件环境,评测漏洞复现和修补能力。
任务与测量
Benchmark 协议档案
- 任务/对象
- 原任务配置下的模型或智能体系统
- 测量目标
- 通过自动构建的可执行软件环境,评测漏洞复现和修补能力。
- 解释边界
- 漏洞复现与修补是不同结果,解释须考虑执行验证和任务构建质量。
测量档案 · NUWA 解读
档案区分来源方法阅读与既有目录信息;已经公开不代表完成独立证据复核或双语编辑复核。
- 测量构念
- 能否构造带可复现漏洞和修补核验的安全智能体数据集?
- 任务与样本
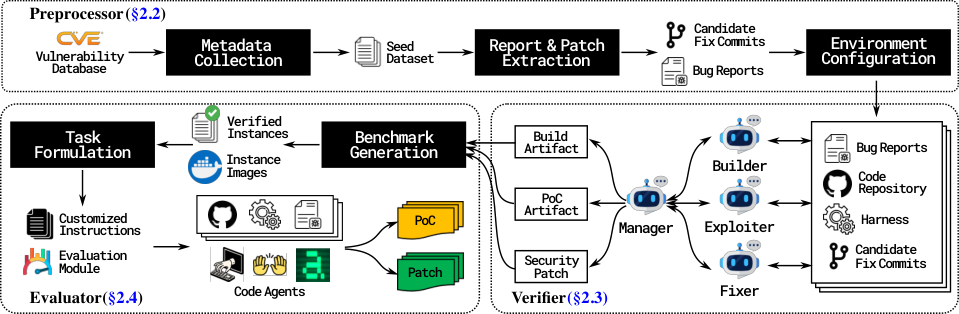
- 自动流水线重建C/C++项目,验证内存安全缺陷,以多个编程框架评测复现和修补。
- 判分与失效情形
- 检测器验证的漏洞复现成功与修补成功分开。
- 系统条件
- C/C++、支持的内存安全缺陷及不同任务提示。
- 统计含义
- 来源报告的结果表述;这不等同于已确定运行次数、分母或估计方法: 完整数据集所报最佳成功率分别18.0%与34.0%。
- 效度与解释
- 基于检测器的内存问题及C/C++覆盖排除了许多其他系统故障(§5)。
- 适用研究问题
- 模型建议:保留任务类型及位置提示,不把检测器复现等同于利用影响。
- SEC-bench: Automated Benchmarking of LLM Agents on Real-World Software Security Tasks · AbstractSelected original resource https://arxiv.org/html/2506.11791; sha256:857cf5e1b82d84f586aabf5eabc8626b00d66bd6ff321c8e170bee6eba519ca6; archived source capture; exact capture time not independently established
- SEC-bench: Automated Benchmarking of LLM Agents on Real-World Software Security Tasks · §3.1 Experimental SetupSelected original resource https://arxiv.org/html/2506.11791; sha256:857cf5e1b82d84f586aabf5eabc8626b00d66bd6ff321c8e170bee6eba519ca6; archived source capture; exact capture time not independently established
- SEC-bench: Automated Benchmarking of LLM Agents on Real-World Software Security Tasks · §3.2 Performance of LLM Agents in Security TasksSelected original resource https://arxiv.org/html/2506.11791; sha256:857cf5e1b82d84f586aabf5eabc8626b00d66bd6ff321c8e170bee6eba519ca6; archived source capture; exact capture time not independently established
- SEC-bench: Automated Benchmarking of LLM Agents on Real-World Software Security Tasks · §5 Limitations and Future WorkSelected original resource https://arxiv.org/html/2506.11791; sha256:857cf5e1b82d84f586aabf5eabc8626b00d66bd6ff321c8e170bee6eba519ca6; archived source capture; exact capture time not independently established
原始来源图表与材料
相关研究问题
参考文献
- [1] Hwiwon Lee Ziqi Zhang Hanxiao Lu † Lingming Zhang. SEC-bench: Automated Benchmarking of LLM Agents on Real-World Software Security Tasks. 2025-06-13. v2 [arXiv]; Author affiliations on the original paper title page; Figure 1